De Workstation-blog
GPU
Berichten met de tag GPU.
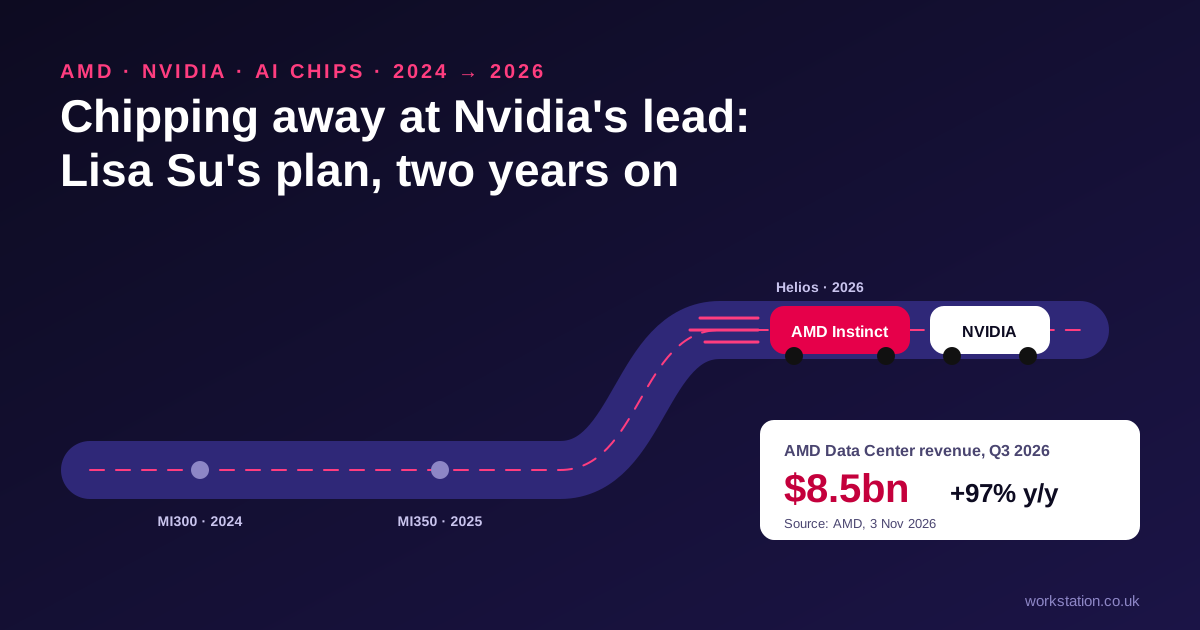
Chipping Away at Nvidia's Lead: Lisa Su's AMD Plan, Two Years On
In December 2024 Bloomberg's The Circuit asked AMD CEO Lisa Su how she would chip away at Nvidia's lead in AI. We check the plan against AMD's 2026 results and Helios launch, and explain what a credible second AI platform means for UK buyers. Includes a link to the interview.
 WorkstationLezen
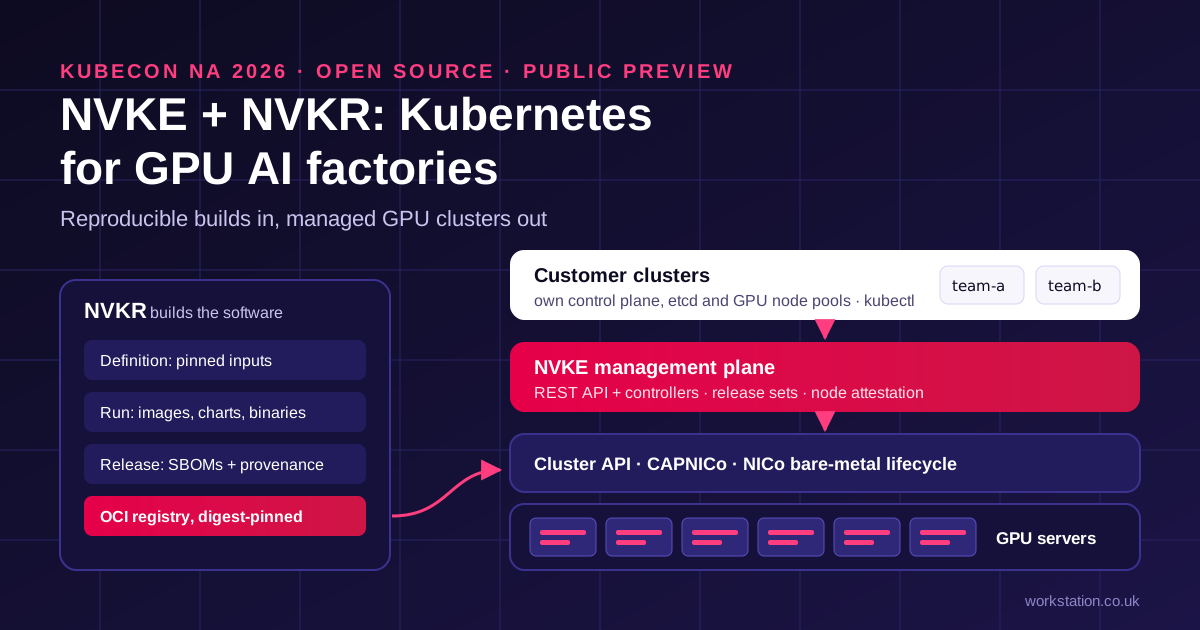
NVIDIA NVKE en NVKR: waarom GPU-Kubernetes het besturingssysteem van de AI-fabriek wordt
NVIDIA heeft NVIDIA Kubernetes Engine (NVKE) en NVIDIA Kubernetes Recipes (NVKR) open source gemaakt om beheerde Kubernetes op GPU-infrastructuur te draaien. Wat ze in gewone taal doen, wat public preview echt betekent, waarom AI-engineering nieuwe vraag naar cloud- en DevOps-vaardigheden creëert, en wie ze nu moet evalueren.
Balinder WaliaLezen 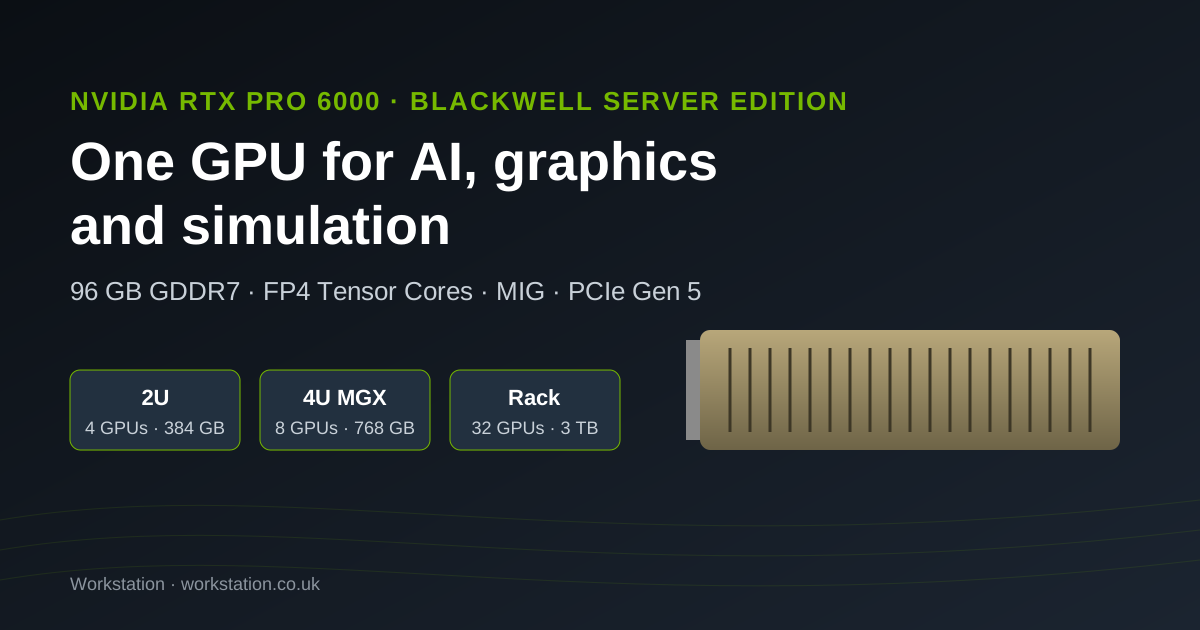
NVIDIA RTX PRO 6000 Blackwell Server Edition: één GPU voor AI, graphics en simulatie in een Britse serverruimte
96 GB GDDR7, FP4 Tensor Cores en RT Cores op een standaard PCIe-kaart: wat de RTX PRO 6000 Blackwell Server Edition van NVIDIA doet, waarom hij geschikt is voor bedrijven die private AI draaien in ruimtes die ze al hebben, de drie systeemgroottes van een 2U-server met vier GPU's tot een rack met 32 GPU's zoals de RackScale 32 van AMAX, en wat u controleert voordat u bestelt.
Balinder WaliaLezen 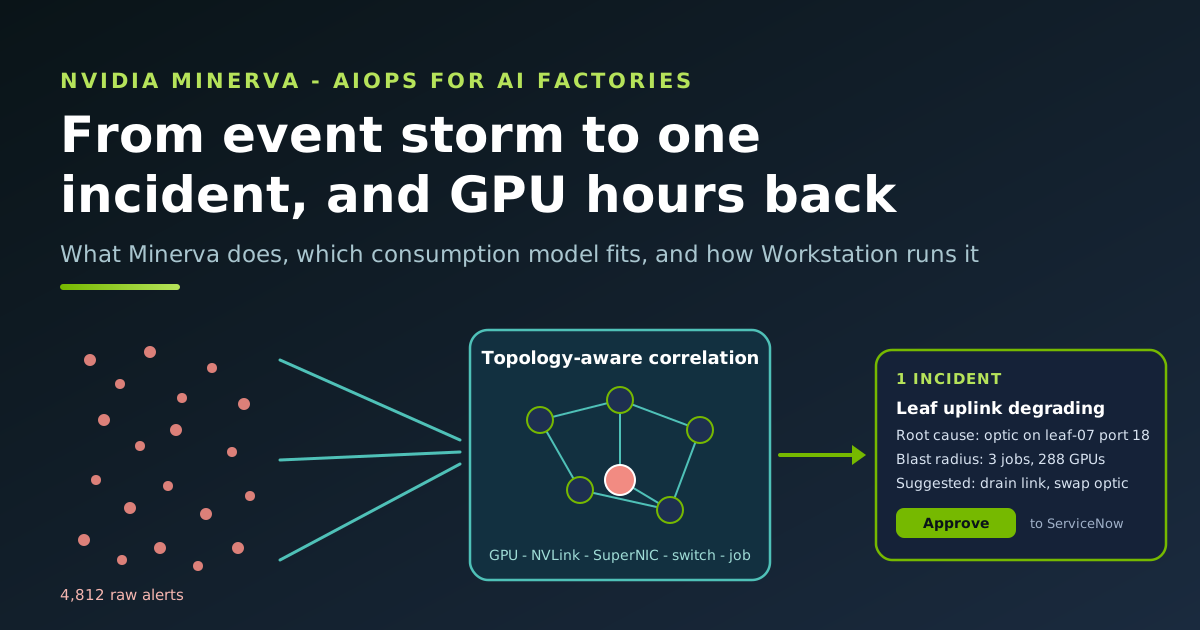
NVIDIA Minerva voor AI-fabrieken: van alertstormen naar teruggewonnen GPU-uren
Eén optiek die achteruitgaat kan duizenden alerts veroorzaken en duizend GPU's stilleggen. Wat NVIDIA Minerva doet, wat het waard is in GPU-uren, goodput, MTBI, MTTR en tokens, welk van de drie afnamemodellen past, uitgewerkte voorbeelden voor een Vera Rubin NVL72-neocloud, een Blackwell-cluster van een universiteit en een organisatie met Grafana en ServiceNow, en hoe het zich verhoudt tot UFM.
Balinder WaliaLezen 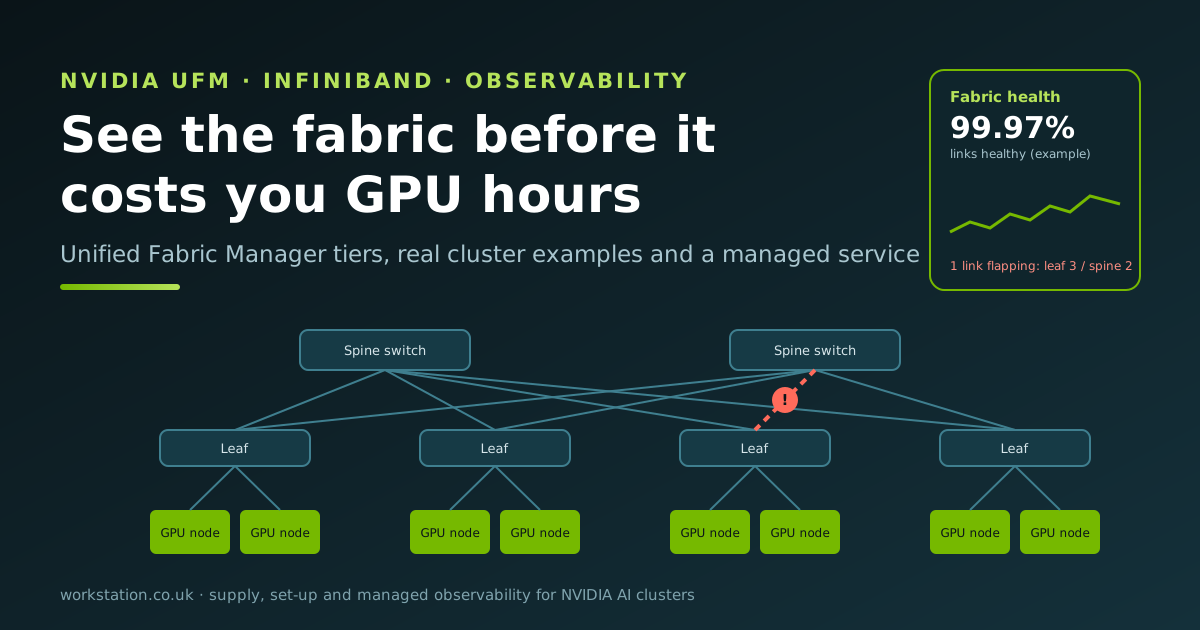
NVIDIA UFM voor AI-clusters: waarom zicht op uw InfiniBand-fabric bepaalt wat uw GPU's waard zijn
Eén flapperende InfiniBand-link kan een job van 256 GPU's stilleggen. Wat NVIDIA Unified Fabric Manager doet, wanneer UFM Telemetry, Enterprise of Cyber-AI past, uitgewerkte voorbeelden voor een DGX B300-cluster van 4 nodes, een cluster van 32 nodes in SuperPOD-stijl en een universitaire Slurm-dienst, en wat zicht op de fabric waard is in GPU-uren.
Balinder WaliaLezen 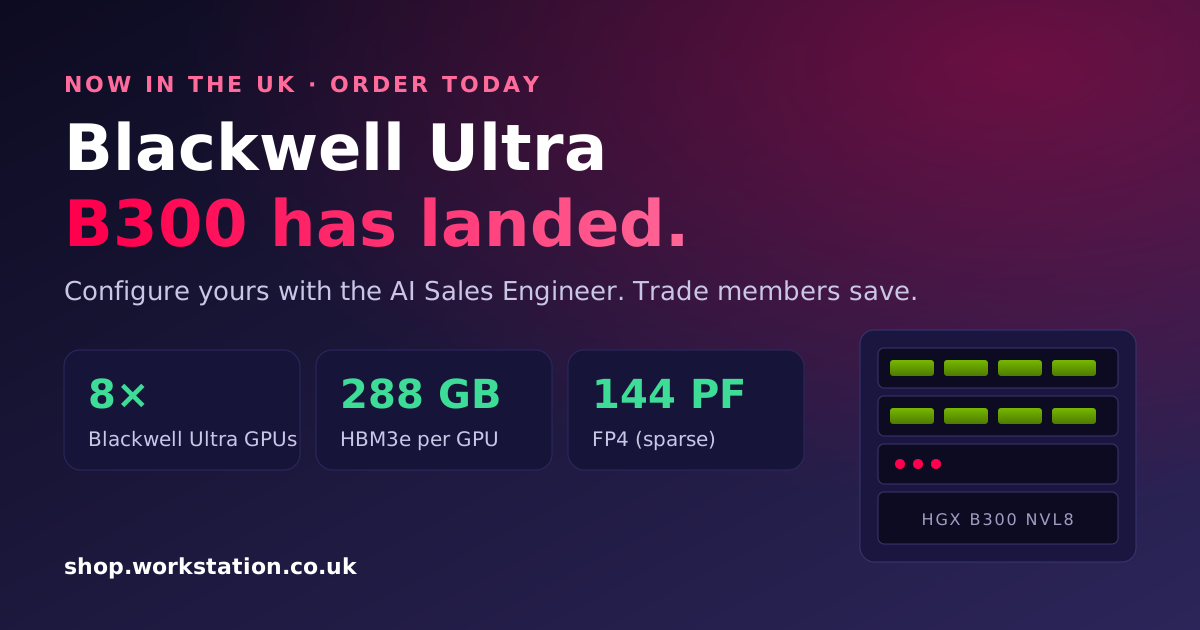
NVIDIA Blackwell Ultra B300 is in het VK geland: configureer de uwe vandaag
NVIDIA Blackwell Ultra B300-systemen zijn aangekomen bij onze Britse distributiepartners. Configureer en prijs uw B300-build met acht GPU's in enkele minuten met onze AI Sales Engineer, bespaar met Workstation Trade en bestel vandaag om als eerste aan de beurt te zijn wanneer de Britse voorraad binnenkomt.
Balinder WaliaLezen 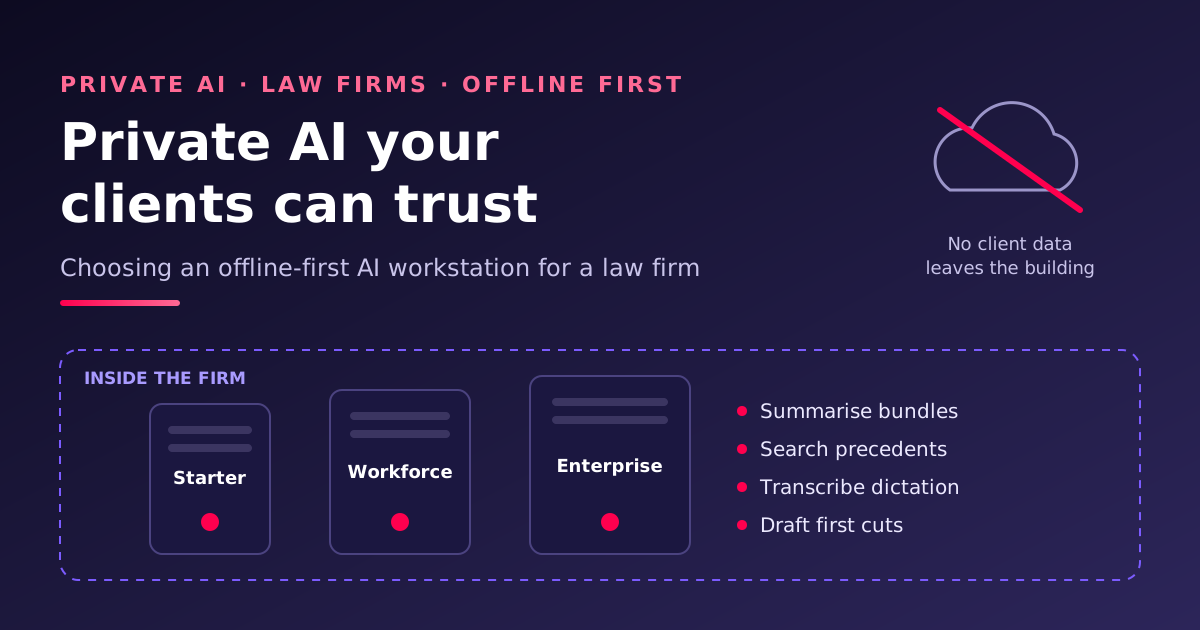
Private AI voor advocatenkantoren: een offline-first workstation kiezen die uw cliënten kunnen vertrouwen
Hoe een advocatenkantoor een private-AI-workstation kiest die zonder internetverbinding draait: wie hem gebruikt, welk model, hoeveel GPU-geheugen, hoe geïsoleerd hij moet zijn en wie hem installeert. Met echte prijzen uit een echte offerte, waar die te zwaar was gespecificeerd, en de Starter-, Workforce- en Enterprise-builds die wij daadwerkelijk zouden leveren.
Balinder WaliaLezen 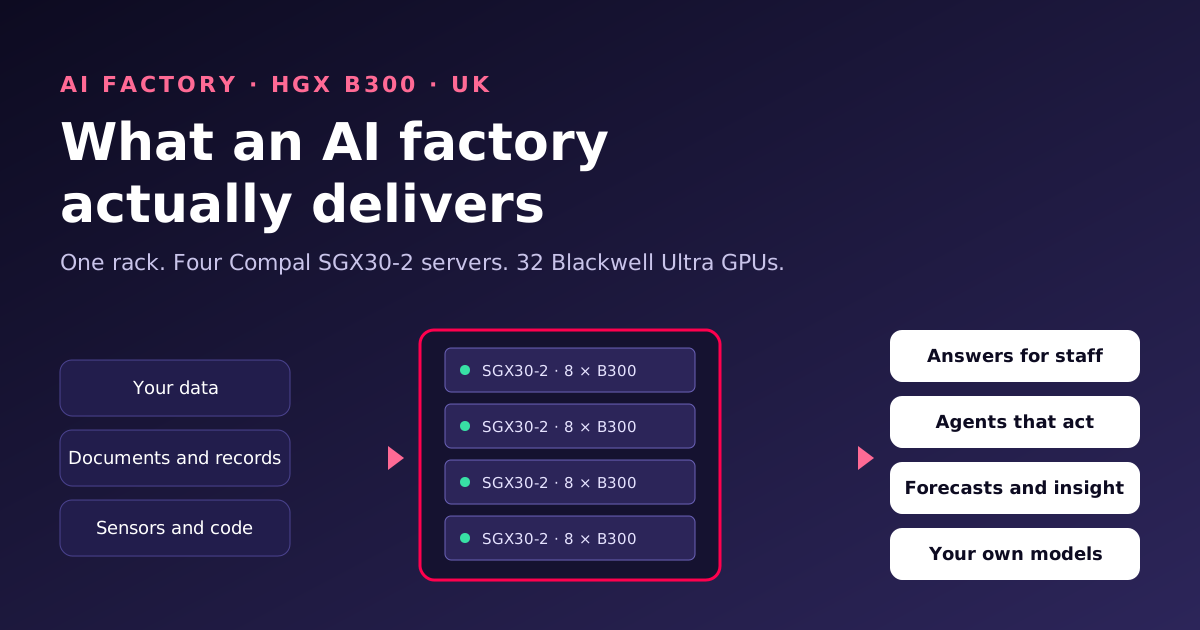
Wat een AI-fabriek werkelijk oplevert: één rack, 32 Blackwell Ultra-GPU's en het werk dat het voor u doet
Een AI-fabriek zet uw eigen data om in antwoorden, agents, prognoses en getrainde modellen op hardware die u zelf beheert. Hier leest u wat erin gaat, wat eruit komt, hoe het werk dagelijks verloopt en wat een rack met vier Compal SGX30-2-servers met 32 NVIDIA Blackwell Ultra-GPU's nodig heeft om te draaien.
Balinder WaliaLezen 
Turbolader LLMs
Workstation op turbo-opladende LLMs: PagedAttention-paging voor KV-cache, vLLM-serving, Self-Debugging voor agenten, PowerInfer-tokensnelheden en EG-MLA-geheugenbesparingen - met productie-afwegingen.
Balinder WaliaLezen 
Grote taalmodellen uitgelegd: hoe LLM's werken en hoe u uw eigen kunt gebruiken op Kubernetes
Wat zijn grote taalmodellen en hoe werken ze? Een duidelijke, niet-technische uitleg voor managers en technici – tokens, inbedding, transformatoren, training en gevolgtrekking – plus productie-Kubernetes YAML om uw eigen LLM te implementeren met Ollama en vLLM.
Balinder WaliaLezen