Wat een AI-fabriek werkelijk oplevert: één rack, 32 Blackwell Ultra-GPU's en het werk dat het voor u doet
Van uw data naar antwoorden, agents en uw eigen modellen, uitgelegd zonder jargon
 Balinder Walia2 november 20268 min read
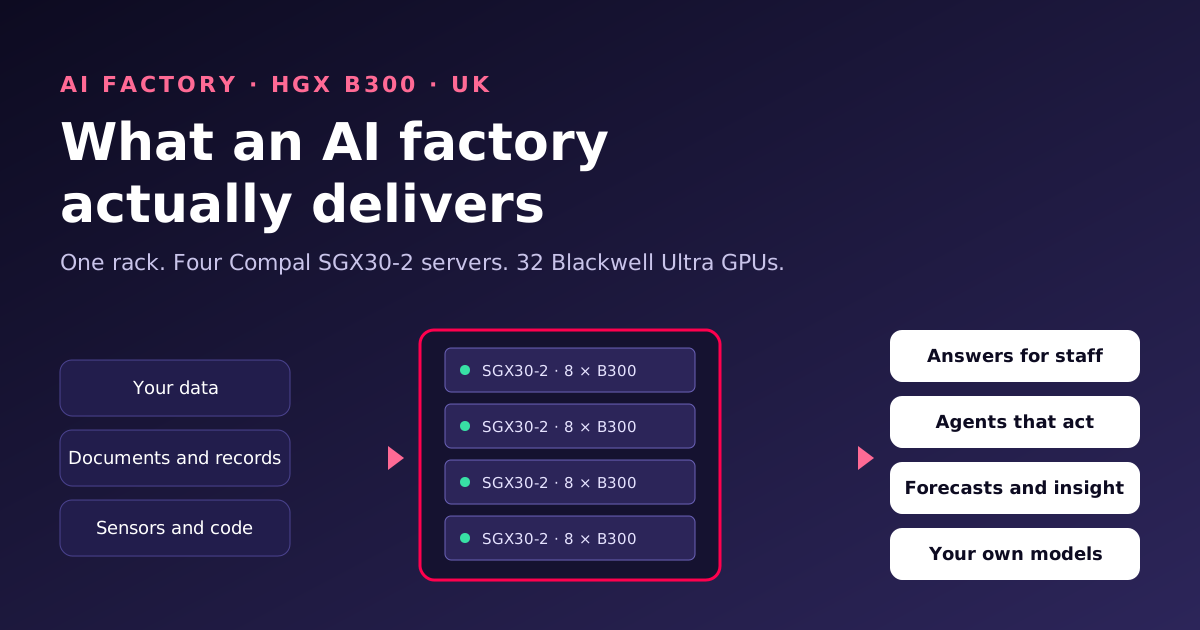
"AI-fabriek" wordt in rap tempo een van die termen die iedereen gebruikt en weinig mensen definiëren. Dit artikel legt in gewone zakelijke taal uit wat een AI-fabriek werkelijk oplevert: wat erin gaat, wat eruit komt, hoe het werk er dagelijks doorheen stroomt en wat u nodig hebt om er een te bezitten en te draaien. We gebruiken overal een echte configuratie, een rack met vier Compal SGX30-2-servers met 32 NVIDIA Blackwell Ultra-GPU's, zodat de getallen concreet zijn. Engineers die de node-architectuur, het netwerkontwerp en de ingebruiknametests willen zien, lezen het technische artikel.

Van informatie opslaan naar informatie produceren
Dertig jaar lang hebben datacenters vooral informatie opgeslagen en geserveerd: websites, databases, e-mail, bestanden. Een AI-fabriek doet iets anders. Ze vervaardigt op aanvraag nieuwe informatie. Een medewerker stelt een vraag over een contract en krijgt een antwoord uit uw eigen documentarchief. Een agent leest een binnenkomende claim, toetst die aan het beleid en stelt een besluit op. Een model dat is getraind op vijf jaar aan onderhoudsgegevens voorspelt welke machine volgende maand uitvalt.
De eenheid van output is het token, een tekstfragment dat een model leest of schrijft. Elk antwoord, elke samenvatting en elke actie van een agent bestaat uit tokens. De vragen die er in een AI-fabriek toe doen, zijn dus dezelfde als in elke fabriek: hoeveel kan ze produceren, hoe goed is de output, wat kost elke eenheid en hoe betrouwbaar draait ze?
Wat erin gaat, wat eruit komt
| Gaat erin | Komt eruit |
|---|---|
| Documenten, contracten, beleidsstukken, handleidingen | Nauwkeurige antwoorden met verwijzingen naar de bron, binnen seconden |
| Tickets, e-mails, chatlogs | Agents die triëren, antwoorden opstellen en werk doorsturen |
| Operationele data en sensordata | Prognoses, meldingen van afwijkingen en onderhoudsvoorspellingen |
| Uw code en engineeringgegevens | Programmeerassistenten die uw systemen en standaarden kennen |
| Feedback over wat werkte | Betere modellen volgende maand: gefinetuned op uw eigen resultaten |
De rechterkolom is waarvoor u betaalt. Het rack is gewoon de machine die het produceert.
De productielijn, fase voor fase

- Innemen. Grondstof komt binnen: documenten, gegevens, tickets, code. Die wordt opgeschoond, ontdubbeld en waar nodig worden persoonsgegevens geredigeerd. Tekst wordt omgezet in embeddings, zodat erop betekenis kan worden gezocht in plaats van op trefwoord.
- Trainen of finetunen. De meeste organisaties trainen geen model vanaf nul. Ze nemen een sterk open model en finetunen het op hun eigen data, zodat het hun taal spreekt en hun producten kent. Met 32 GPU's is dat een klus van uren of dagen, niet van maanden.
- Evalueren en promoveren. Voordat een nieuw model medewerkers of klanten bereikt, wordt het getest op nauwkeurigheid, veiligheid, kosten en snelheid. Modellen die slagen, worden stap voor stap gepromoveerd van een testring naar productie, net zoals goede softwareteams code uitbrengen. Wij gebruiken hiervoor onze eigen Ring Promoter, zodat elke release een audittrail heeft en kan worden teruggedraaid.
- Serveren. Hier ontstaat de waarde: chatassistenten, documentzoeken, agents en API's die de hele dag verzoeken beantwoorden. Toegang loopt via WSL Proxy, dat versleuteling, aanmelding en web application firewalling verzorgt, en sleutels en credentials staan in WSL Vault in plaats van in de code.
- Verbeteren. Elke interactie vertelt u iets: welke antwoorden hielpen, welke werden gecorrigeerd, waar agents vastliepen. Die feedback wordt de trainings- en testdata voor de volgende ronde. Deze lus is de reden dat een AI-fabriek in de loop van de tijd waardevoller wordt, in plaats van af te schrijven zoals gewone IT.
Onder alle vijf fasen verdeelt een scheduler de GPU's over teams en taken, zodat training 's nachts kan draaien op capaciteit die overdag medewerkers bedient. Stilstaande GPU's zijn het duurste in een AI-fabriek, en goede planning is hoe u dat voorkomt.
Wat er in het rack zit, en wat elk onderdeel doet
Onze standaardbouwsteen is de Compal SGX30-2, een NVIDIA-Certified server voor het HGX B300-platform. Vier daarvan vormen één rack. Dit is wat elke server bevat, in gewone taal.
| Onderdeel | Per server | Wat het voor u doet |
|---|---|---|
| NVIDIA HGX B300 NVL8-baseboard | 8 Blackwell Ultra-GPU's, elk met 288 GB geheugen | De motor. Draait en traint de modellen. Veel geheugen betekent dat grote modellen en lange documenten zonder concessies passen. |
| Intel Xeon 6-processors | 2 (6767P, 6776P of 6768P) | Bereidt data voor, draait het besturingssysteem en houdt de GPU's gevoed. |
| DDR5-6400 ECC-geheugen | 32 × 96 GB (3 TB) | Werkruimte voor het laden van data en voor het parkeren van modelgeheugen wanneer GPU's bezet zijn. |
| NVMe E1.S-schijven | 8 × 3,84 TB | Snelle lokale opslag voor datasets, modelbestanden en trainingscheckpoints. |
| M.2-bootschijven | 2 × 960 GB | Besturingssysteem, gespiegeld zodat één storing de server niet stillegt. |
| NVIDIA ConnectX-8 SuperNICs | 8 onboard, 8 × 800G-poorten | Een eigen lijn van 800 Gb/s voor elke GPU, zodat 32 GPU's in vier servers samen aan één taak kunnen werken. |
| NVIDIA BlueField-3 B3240 | 1 | Verwerkt opslag- en gebruikersverkeer apart, met ingebouwde beveiliging en isolatie. |
| Voedingen | 12 × 3200 W Titanium, 6+6 redundant | De helft kan uitvallen, of één stroomvoeding kan wegvallen, en de server blijft draaien. |
| Garantie | 3 jaar return-to-base | Reparaties en vervangingen geregeld via ons. |
Over het hele rack komt dat neer op 32 GPU's, ongeveer 8,4 TB GPU-geheugen, 12 TB systeemgeheugen en ongeveer 123 TB snelle lokale opslag, allemaal verbonden door een netwerkfabric van 800 Gb/s per GPU.
Wat die capaciteit in de praktijk betekent
We zijn voorzichtig met het beloven van prestatiecijfers die we niet op uw workload hebben gemeten, omdat de werkelijke doorvoer afhangt van het model, de lengte van de vragen en antwoorden en hoeveel mensen het tegelijk gebruiken. Maar sommige dingen volgen direct uit het geheugen en het ontwerp:
- Grote open modellen passen ruim. Eén server heeft 2,1 TB GPU-geheugen, zodat zelfs modellen met enkele honderden miljarden parameters vanaf één server kunnen worden geserveerd, met ruimte over voor lange gesprekken.
- Meerdere diensten kunnen naast elkaar draaien. Eén server kan uw hoofdassistent hosten terwijl een andere documentzoeken en embeddings draait, en de overige twee agents en finetuning 's nachts afhandelen.
- Trainingstaken kunnen het hele rack gebruiken. Wanneer een finetuningrun alle 32 GPU's nodig heeft, laat de fabric van 800 Gb/s vier servers als één werken, en geeft de scheduler de capaciteit daarna terug aan het serveren.
- Het is gebouwd voor reasoning-modellen. Blackwell Ultra verdubbelt de snelheid van de "attention"-berekeningen in het hart van moderne modellen ten opzichte van de eerste Blackwell-generatie, wat het zwaarst weegt wanneer modellen een probleem doordenken voordat ze antwoorden.
Bezitten versus huren
Cloud-GPU's zijn uitstekend voor experimenten en korte pieken. De economie verandert zodra AI onderdeel wordt van het dagelijkse werk. Gehuurde capaciteit wordt per uur gefactureerd, of ze nu bezet is of niet, en de prijs, beschikbaarheid en voorwaarden zijn van iemand anders. Eigen capaciteit is een vaste kost: elke extra beantwoorde vraag, elke agentrun of elk getraind model verlaagt de kosten van elk afzonderlijk.
Er zijn ook andere redenen dan kosten. Met een AI-fabriek op uw eigen infrastructuur verlaten uw data, prompts en output nooit het VK of uw controle, wat gesprekken over UK GDPR, met toezichthouders en met klanten aanzienlijk eenvoudiger maakt. U krijgt ook capaciteit wanneer u die nodig hebt, zonder quotumaanvragen of wachten tot een cloudregio vrijkomt.
Het is niet voor iedereen geschikt. Als u AI incidenteel gebruikt, of maar een paar weken grote capaciteit nodig hebt, is huren meestal goedkoper. We vertellen u eerlijk aan welke kant van die lijn u staat.
Wat u nodig hebt om het te hosten
- Stroom: elke server heeft in de orde van 14 kW nodig en het rack rond de 60 kW. Dat sluit de meeste gewone serverruimtes in kantoren uit, maar veel Britse colocatiehallen kunnen het leveren.
- Koeling: de SGX30-2 is luchtgekoeld, dus er is geen installatie voor vloeistofkoeling nodig, maar de hal moet racks met hoge dichtheid aankunnen, met hot-aisle containment.
- Ruimte: 40U rackruimte voor de vier servers, plus netwerkswitches en opslag.
- Tijd: NVIDIA-datacenter-GPU's worden toegewezen door NVIDIA en de serverfabrikanten, en levertijden worden in maanden gemeten. Locatievoorbereiding en ontwerp gebeuren terwijl u wacht, zodat de fabriek kort na levering live kan gaan.
- Papierwerk: geavanceerde GPU's vallen onder Britse en Amerikaanse exportcontroles, dus we bevestigen de eindgebruiker, het beoogde gebruik en de installatielocatie voordat we de levering kunnen bevestigen.
Wie het beheert zodra het live is
Een fabriek die niet goed wordt beheerd, verliest langzaam output aan storingen, drift en beveiligingslekken. Wij kunnen de uwe zoveel of zo weinig beheren als u wilt. Onze SysOps247-dienst bewaakt de GPU-gezondheid, temperaturen, fouten en capaciteit de klok rond, past firmware- en beveiligingsupdates toe in geplande vensters en handelt storingen en garantieretouren af. Uw teams richten zich op het werk dat de fabriek produceert.
Een verstandige manier om te beginnen
- Schrijf het werk op. Welke vragen, beslissingen en documenten zou u als eerste aan AI overdragen, en hoeveel mensen zouden het gebruiken?
- Controleer de locatie. Hebt u, of kunt u huren, rackruimte van ongeveer 60 kW? Wij kunnen die onderzoeken of een shortlist van colocatieopties maken.
- Begin met één rack, of zelfs één server. Alles wordt volgens een referentieontwerp gebouwd, zodat er later meer servers en racks bij kunnen zonder herontwerp.
- Plan de eerste drie diensten. Meestal een assistent voor medewerkers over uw documenten, één agent voor een goed afgebakend proces en één gefinetuned model. Bewijs daar de waarde, en groei dan.
Waar u verder kunt
- Voor de node-architectuur, de vier netwerken, de softwarestack, de rekensommen voor modeldimensionering en de acceptatietests leest u het technische artikel: Binnen in een HGX B300 AI-fabriek met 32 GPU's.
- Bekijk de AI-fabrieksoplossingen die we bouwen, van RTX PRO-servers tot GB300 NVL72, en de pagina's over de Compal SGX30-2 en het HGX B300-rack met 32 GPU's.
- De SGX30-2 is te bestellen in onze shop. De prijs wordt bevestigd in een schriftelijke offerte.
- Plant u iets vergelijkbaars? Neem contact met ons op.