De shop is live

Wij bouwen Workstation AI-machines voor websites, AI-agents en LLM-training — configureer en koop online.

Bekijk handelsprijzen
AI-producten
AI LabsOpenAI-agentsClaude-agentsGrok-botWorkstation AI native CRMMarketingAlle producten
AI-oplossingen
Toegepaste AIAI-agentsGeneratieve AIAI-automatiseringAI-bijscholingAI-pakketten voor het mkbEnterprise AI LabAI-werkstationsNVIDIA-hardware en -softwareNVIDIA Accelerated ComputingPrivate AIGPU private cloudGPU-clustersEdge AIAI per sector
AI-diensten
PlatformmoderniseringDigitale engineeringDatafundamenten en AIAutonome operatiesAI-adviesDevOps-automatiseringCybersecuritySoftwareontwikkelingAgentontwikkelingMLOps-opzetGPU-leasingGPU private cloud
Over ons
BedrijfOns verhaalPartnersKlantverhalen
AI-datacenters
AI-datacentersGPU private cloudGPU-clustersGPU-leasing
AI-inzichtenJev-reeksBenchmarklabModelkeuze
Technische notities
Documentatie
Linux-OSUbuntuRed Hat Enterprise LinuxSUSE LinuxAlpine LinuxDebian, Rocky & AlmaLinux
AI-cloudplatformsAWS & Amazon BedrockGoogle Cloud & Vertex AIMicrosoft Azure & AI FoundryGPU-clouds en -marktplaatsen
Private AI-datacentersVoor advocatenkantorenVoor accountantskantorenOn-premises platformsVolledig beveiligde cloud
ToolsRing PromoterJobshout
Nieuws
Blog
Neem contact opInloggen

AI-werkstations, AI multi-agent software, GPU-infrastructuur en intelligente agentoplossingen voor moderne bedrijven.

Neem contact op

AI-oplossingen

Toegepaste AIAI-agentsGeneratieve AIAI-automatiseringAI-bijscholingAI-pakketten voor het mkbEnterprise AI LabAI per sector

Producten

Alle productenWorkstation AI-native CRM & ERPMarketingOpenAI-agentsRing PromoterJobshout

Bedrijf

Over onsBedrijfAI-datacentersWaarom WorkstationPartnersKlantverhalenPrijzenContactTenthMatrix

Bronnen

AI-inzichtenTechnische notitiesDocumentatieLinux-OSAI-cloudplatformsPrivate AI-datacentersBlogZoekenSitemap
Kantoor België
Workstation SRL, Rue Vanderkindere 34, 1180 Uccle, BrusselsBE 0751.518.683Ma - Vr: 9:00 - 18:00 CET
+32 492 45 67 46
Hoofdkantoor VK
77-79 Marlowes, Hemel Hempstead HP1 1LFRoute: neem afrit 20 van de M25, Outer LondonBedrijfsnummer: 11641870Ma - Vr: 9:00 - 18:00 GMT
+44 7515 356 146
Kantoor India
#159 Sector 9, Pocket 1, DDA Flats, 110077 Dwarka, New Delhi
+91 98881 98841
Kantoor Taiwan
3F, No. 2-4, Aisi Rd., Ren'ai Dist., Keelung City 200, Taiwan基隆市仁愛區愛四路2之4號3樓Ma - Vr: 9:00 - 18:00 Taiwanese tijd (GMT+8)
+886 926 892 701+32 492 45 67 46
Kantoor Estland
Aleksander Puškini tn 30-25, 20306 Narva, EstoniaMa - vr: 9:00 - 18:00 uur Estse tijd (EET)
+32 492 45 67 46

© 2026 Workstation AI. Alle rechten voorbehouden.

PrivacyGegevensverwijderingCookiesServicevoorwaardenWebsite-sitemap

NVIDIA, het NVIDIA-logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, DGX en HGX zijn handelsmerken en/of gedeponeerde handelsmerken van NVIDIA Corporation in de VS en andere landen. AMD, het AMD Arrow-logo, EPYC, Instinct, Ryzen en Threadripper zijn handelsmerken van Advanced Micro Devices, Inc. Dell en PowerEdge zijn handelsmerken van Dell Inc. of haar dochterondernemingen. Intel en Xeon zijn handelsmerken van Intel Corporation of haar dochterondernemingen. AMAX, AceleMax en LiquidMax zijn handelsmerken van AMAX Engineering Corporation. Alle andere productnamen, logo's en merken zijn eigendom van hun respectieve eigenaren. Wij gebruiken ze uitsluitend om de producten aan te duiden die wij beschrijven, leveren of ondersteunen; het gebruik ervan betekent niet dat de eigenaren ons onderschrijven.

GPU private cloud

Uw eigen AI-cloud: GPU's, opslag en software in een datacenter dat u zelf beheert

Draai AI-assistenten, agents, zoekfuncties en modeltraining op GPU's die alleen voor u zijn, naast uw data en tegen voorspelbare kosten. Wij ontwerpen, bouwen en beheren GPU private clouds van één server tot complete racks, op uw eigen locatie of in een Brits datacenter.

Op deze pagina

  1. Wat een GPU private cloud is
  2. Waarom organisaties hun eigen GPU-cloud bouwen
  3. Bekijk de hardware: officiële video's van NVIDIA, Dell en AMD
  4. GPU's, VRAM en servers
  5. Hoeveel VRAM hebt u nodig?
  6. Opslag die GPU's aan het werk houdt
  7. Het netwerk tussen GPU's
  8. Alles wat een complete GPU private cloud omvat
  9. Private, publiek of hybride: vergeleken
  10. Een GPU private cloud vanaf nul bouwen
  11. Probeer het: het private AI-cloudlab
  12. Veelgestelde vragen over een GPU private cloud

Probeer het: het private AI-cloudlab

Wat een GPU private cloud is

Een GPU private cloud geeft uw teams de selfservice-ervaring van een publieke cloud (kies een model, start een notebook, rol een assistent uit) op GPU-servers die alleen u gebruikt. De hardware staat op uw eigen locatie of in een colocatiedatacenter, en de platformsoftware, het beveiligingsbeleid en de data blijven volledig onder uw beheer.

De publieke cloud is uitstekend om ideeën uit te proberen en korte pieken op te vangen. Maar AI-assistenten en agents draaien de hele dag, elke interactie wordt gemeten en de data die ze nodig hebben is vaak juist de data die u het minst kunt verplaatsen. Zodra het gebruik stabiel is, maakt een private cloud de kosten meestal voorspelbaar, houdt hij gevoelige data op één plek en verkort hij de latentie tussen uw modellen en uw systemen.

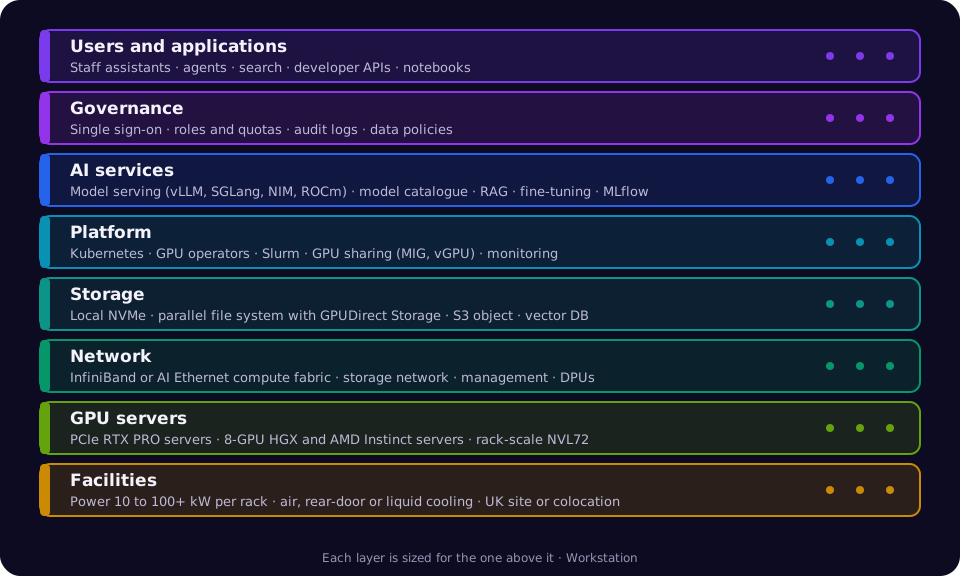
Het is niet één product. Een private AI-cloud is een stack: stroom en koeling, GPU-servers, een snel netwerk, opslag die GPU's aan het werk kan houden, een container- en schedulingplatform, model serving en datatools, en de governance daaromheen. De rest van deze pagina loopt elke laag door en laat u daarna de opties voor uw eigen workloads uitproberen.

Diagram van de GPU-private-cloudstack, van de faciliteiten onderaan, via GPU-servers, netwerk en opslag, tot het platform, AI-diensten en governance bovenaan, met gebruikers en applicaties daarboven.
De acht lagen van een GPU private cloud. Elke laag moet zijn gedimensioneerd voor de laag erboven.

Terug naar inhoud

Waarom organisaties hun eigen GPU-cloud bouwen

De redenen die we het vaakst horen, en wat elk ervan in de praktijk betekent.

Voorspelbare kosten voor AI die altijd aan staat

Assistenten, agents en API's die 24/7 draaien, kosten op eigen of geleasede hardware elke maand hetzelfde, in plaats van een rekening die met elk token en elke gebruiker groeit.

Data blijft waar u dat wilt

Houd klant-, patiënt-, juridische of financiële data in het VK, op uw eigen locatie of volledig offline, en toon dat aan bij auditors en toezichthouders.

Lage latentie naast uw data

Modellen draaien naast uw databases, documenten en applicaties, zodat retrieval en toolaanroepen van agents niet bij elke stap over het internet gaan.

Vrijheid in modellen en tools

Draai open-weight modellen, uw eigen gefinetunede modellen en commerciële modellen naast elkaar, en wissel ze zonder van platform te veranderen. Geen lock-in aan de catalogus van één provider.

Ingebouwde governance

Single sign-on, rolgebaseerde toegang, quota per team, auditlogs van elke modelaanroep en beleid over welke data elke assistent mag gebruiken.

Selfservice voor elk team

Data scientists starten notebooks en fine-tuningjobs, developers rollen modelendpoints uit en IT houdt één console voor capaciteit, gezondheid en kosten.

Gegarandeerde GPU-capaciteit

Uw GPU's zijn er wanneer een project start, niet uitverkocht in de regio die u nodig hebt. De scheduling bepaalt welk team ze krijgt, niet een wachtrij bij een provider.

Hardware die zich blijft terugverdienen

Oudere GPU's schuiven door naar inferentie, ontwikkeling en onderwijs wanneer er nieuwe komen, zodat elke generatie jarenlang blijft renderen.

Terug naar inhoud

Bekijk de hardware: officiële video's van NVIDIA, Dell en AMD

Afgespeeld vanaf het eigen YouTube-kanaal van elke fabrikant. Elke video wordt pas geladen wanneer u op afspelen drukt.

The AI Factory. Afgespeeld vanaf het officiële YouTube-kanaal van NVIDIA. Bekijk op YouTubeNVIDIA, Blackwell, DGX, Grace en RTX PRO zijn handelsmerken en/of gedeponeerde handelsmerken van NVIDIA Corporation. Ze worden getoond om de producten die wij leveren te beschrijven; dit impliceert geen goedkeuring door NVIDIA.
How Dell Technologies Is Building the Engines of AI Factories With NVIDIA Blackwell. Afgespeeld vanaf het officiële YouTube-kanaal van NVIDIA. Bekijk op YouTubeDe getoonde productnamen zijn handelsmerken of gedeponeerde handelsmerken van NVIDIA and Dell Technologies. Ze beschrijven de producten die wij leveren; dit impliceert geen goedkeuring.
AMD Helios Rackscale Solution: Open AI Infrastructure for the AI Factory Era. Afgespeeld vanaf het officiële YouTube-kanaal van AMD. Bekijk op YouTubeDe getoonde productnamen zijn handelsmerken of gedeponeerde handelsmerken van AMD. Ze beschrijven de producten die wij leveren; dit impliceert geen goedkeuring.

Terug naar inhoud

GPU's, VRAM en servers

Het GPU-geheugen (VRAM) bepaalt welke modellen passen en hoeveel gebruikers elke GPU kan bedienen; de geheugenbandbreedte bepaalt hoe snel die antwoordt. Dit zijn de datacenter-GPU's waarmee we het vaakst private clouds bouwen.

Datacenter-GPU's vergeleken

GPUFabrikantGeheugen per GPUGeheugenbandbreedteVormfactorGeschikt voor
RTX PRO 6000 Blackwell Server EditionNVIDIA96 GB GDDR71,6 TB/sPCIe-kaart, luchtgekoeldInferentie, RAG, fine-tuning van kleine en middelgrote modellen, graphics en simulatie
L40SNVIDIA48 GB GDDR6864 GB/sPCIe-kaart, luchtgekoeldInferentie van kleine modellen, vision, rendering
H200NVIDIA141 GB HBM3e4,8 TB/sHGX-board met 8 GPU'sInferentie en fine-tuning van grote modellen
B200NVIDIA180 GB HBM3e8 TB/sHGX-board met 8 GPU'sTraining en inferentie met hoge doorvoer
B300 (Blackwell Ultra)NVIDIA288 GB HBM3e8 TB/sHGX-board met 8 GPU's, lucht- of vloeistofkoelingReasoningmodellen, zeer grote modellen, training
GB300 NVL72NVIDIA288 GB HBM3e per GPU, 72 GPU's per rack8 TB/s per GPUVloeistofgekoeld rackFrontier-training en de grootste inferentiediensten
Instinct MI325XAMD256 GB HBM3E6 TB/sOAM-platform met 8 GPU'sInferentie van grote modellen met veel geheugen per GPU
Instinct MI355XAMD288 GB HBM3E8 TB/sOAM-platform met 8 GPU's, vloeistofkoelingTraining en inferentie van zeer grote modellen
DGX Spark (GB10)NVIDIA128 GB unified273 GB/sSysteem naast het bureauOntwikkeling, prototyping en pilots vóór het cluster

De cijfers zijn de gepubliceerde specificaties van de fabrikanten. Partnerservers kunnen GPU's met andere vermogenslimieten laten draaien.

Servers waarin ze passen

PCIe-GPU-servers

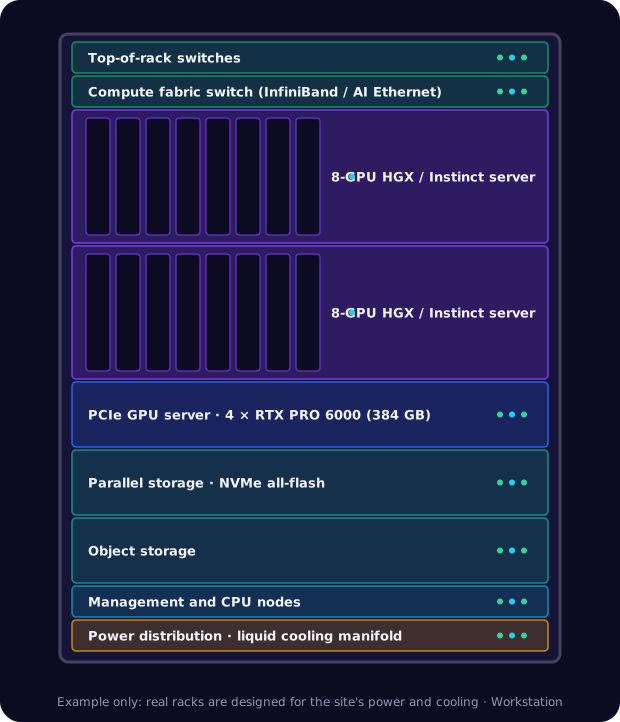
Twee tot acht PCIe-GPU's zoals RTX PRO 6000 of L40S in een standaard luchtgekoelde server, bijvoorbeeld Dell PowerEdge XE7745 of R760xa. De eenvoudigste instap in een private cloud: past in de meeste racks en stroombudgetten.

HGX- en OAM-servers met 8 GPU's

Acht GPU's verbonden via NVLink of AMD Infinity Fabric, bijvoorbeeld Dell PowerEdge XE9680 (H200 of AMD Instinct MI300X), XE9780 (B300) en XE9785 (AMD Instinct MI355X), of NVIDIA DGX B200 en DGX B300.

Systemen op rackschaal

Complete vloeistofgekoelde racks die als één gigantische GPU werken, zoals NVIDIA GB300 NVL72 of AMD Helios. Voor organisaties die de grootste modellen trainen of serveren, in een datacenter dat daarvoor is gebouwd.

AI-systemen naast het bureau

DGX Spark en AI-workstations voor developers en pilots. Dezelfde softwarestack als het cluster, zodat werk ongewijzigd kan worden overgezet.

Terug naar inhoud

Hoeveel VRAM hebt u nodig?

Een snelle manier om het GPU-geheugen te bepalen voordat u met iemand praat. Gebruik de sizer verderop voor uw eigen cijfers.

  • Modelgewichten: ongeveer 2 GB per miljard parameters bij 16-bit, 1 GB bij 8-bit (FP8) en 0,5 GB bij 4-bit.
  • KV-cache: het gesprek van elke gebruiker heeft ook geheugen nodig, dat groeit met de contextlengte en het aantal gelijktijdig bediende gebruikers. Bij drukke diensten kan dat net zo groot worden als de gewichten.
  • Marge: houd ongeveer 10 tot 20% vrij voor de runtime, activaties en pieken.
  • Fine-tuning vraagt meer: volledige fine-tuning kan drie tot vier keer zoveel geheugen kosten als inferentie; LoRA en QLoRA hebben veel minder nodig.
  • Mixture-of-experts-modellen moeten al hun experts in het geheugen hebben, ook al worden er per woord maar enkele gebruikt.
ModelgroottePrecisieGeheugen voor gewichtenPast op (met ruimte voor gebruikers)
8 miljard parameters16-bitongeveer 16 GBEén L40S of RTX PRO 6000; DGX Spark
32 miljard parameters8-bitongeveer 32 GBEén RTX PRO 6000
70 miljard parameters8-bitongeveer 70 GBEén H200 of twee RTX PRO 6000
120 miljard parameters (MoE)4-bitongeveer 60 tot 65 GBEén RTX PRO 6000 of H200
405 miljard parameters8-bitongeveer 405 GBEén server met 8 GPU's H200, B200 of MI325X
670 miljard parameters en meer (MoE)8-bitongeveer 670 GB of meerEén server met 8 GPU's B300 of MI355X, of meerdere servers

VRAM-calculator

Terug naar inhoud

Opslag die GPU's aan het werk houdt

GPU's die op data wachten, verspillen geld. AI-opslag bestaat meestal uit drie lagen, gedimensioneerd op de leessnelheid die training vraagt en de capaciteit die uw data nodig heeft.

Lokale NVMe in elke server

Snelle scratchruimte voor datasets, checkpoints en modelcaches, dicht bij de GPU's. Doorgaans meerdere NVMe-schijven per GPU-server.

NVMe-SSD's in elke GPU-server

Gedeeld high-performance bestandssysteem

Eén namespace die alle servers parallel lezen, snel genoeg om training te voeden en modellen in seconden te laden. Let op ondersteuning voor GPUDirect Storage, dat data rechtstreeks naar het GPU-geheugen verplaatst.

Dell PowerScale, VAST Data, WEKA, DDN, IBM Storage Scale, Lustre

Objectopslag en back-up

Grote, goedkope capaciteit voor ruwe data, datasets, modelversies en back-ups, via de S3-interface die de meeste AI-tools al spreken.

Dell ECS of ObjectScale, Ceph, S3-compatibele appliances, tape of cloud voor externe kopieën

Vector- en documentstores voor RAG

Assistenten die antwoorden op basis van uw documenten hebben een vectordatabase en de originele bestanden nodig, met dezelfde toegangscontroles als de bronsystemen. Bijvoorbeeld pgvector, Milvus, Qdrant of Elasticsearch.

Terug naar inhoud

Het netwerk tussen GPU's

Binnen een server communiceren GPU's via NVLink of Infinity Fabric. Tussen servers bepaalt het netwerk of veel GPU's als één kunnen werken.

Compute-fabric

Voor training of serving over meerdere servers: NVIDIA Quantum InfiniBand (400 tot 800 Gb/s per poort), NVIDIA Spectrum-X Ethernet, of Ethernet met AMD Pensando Pollara AI NIC's. Meestal één poort van 400 of 800 Gb/s per GPU.

Opslag- en front-endnetwerk

Een apart Ethernet-netwerk voor opslagverkeer, gebruikers en applicaties, doorgaans 100 tot 400 Gb/s per server, zodat het nooit concurreert met de compute-fabric.

Beheer en beveiliging

Out-of-band-beheer voor elke server, DPU's zoals NVIDIA BlueField om tenants te isoleren en beveiliging te offloaden, en firewalls tussen de AI-cloud en de rest van de organisatie.

Terug naar inhoud

Alles wat een complete GPU private cloud omvat

Onze checklist voor een private AI-cloud die teams echt gebruiken. We vinken deze punten af bij ontwerp, bouw en overdracht.

Faciliteiten

  • Vermogen per rack gedimensioneerd voor GPU-servers (10 kW tot meer dan 100 kW)
  • Bijpassende lucht-, achterdeur- of directe vloeistofkoeling
  • Redundante stroomvoedingen en UPS
  • Vloerbelasting, toegangscontrole en brandblussing gecontroleerd
  • Locatieonderzoek van een Brits datacenter of eigen locatie

Rekenkracht

  • GPU-servers afgestemd op modelgroottes en gebruikers
  • Nodes met alleen CPU voor datavoorbereiding en diensten
  • Reservecapaciteit of reserveonderdelen voor storingen
  • Firmware- en driverbaselines samen getest
  • Burn-in en benchmark vóór de overdracht

Netwerk

  • InfiniBand- of AI-Ethernet-compute-fabric
  • Aparte opslag- en front-endnetwerken
  • Out-of-band-beheernetwerk
  • Segmentatie ten opzichte van het bedrijfsnetwerk
  • Optionele DPU's voor tenantisolatie

Opslag

  • Lokale NVMe-scratch in elke server
  • Gedeeld parallel bestandssysteem met GPUDirect Storage
  • S3-compatibele objectopslag
  • Snapshots, back-up en externe kopieën
  • Vectordatabase voor RAG

Platform

  • Kubernetes met de NVIDIA of AMD GPU Operator
  • Slurm of een Kubernetes-batchscheduler voor trainingsjobs
  • GPU-deling: MIG, time-slicing of vGPU
  • Quota en prioriteiten per team
  • Imageregistry en infrastructure as code

AI-diensten

  • Model serving: vLLM, SGLang, NVIDIA Dynamo en NIM, of AMD ROCm-images
  • Een modelcatalogus met goedgekeurde open en commerciële modellen
  • Chat- en assistentfront-end voor medewerkers
  • RAG-pipelines gekoppeld aan uw documentopslag
  • Notebooks, fine-tuning en experimenttracking (MLflow)

Beveiliging en governance

  • Single sign-on en rolgebaseerde toegang
  • Secretsbeheer en versleuteling in rust en tijdens transport
  • Auditlogs van elke modelaanroep en elke datatoegang
  • Beleid over welke data elke assistent mag gebruiken
  • Air-gapped optie voor gerubriceerd of gereguleerd werk

Beheer

  • Monitoring van GPU-gezondheid en -gebruik (DCGM, Prometheus, Grafana)
  • Kosten- en gebruiksrapporten per team
  • Proces voor patches en driver- en modelupgrades
  • Capaciteitsplanning voor de volgende GPU-generatie
  • Optionele managed service en on-call-ondersteuning

Terug naar inhoud

Private, publiek of hybride: vergeleken

De gebruikelijke afwegingen. De meeste organisaties komen uit op hybride: een private basis voor stabiel werk en de publieke cloud of geleasede capaciteit voor pieken.

AI-diensten in de publieke cloudGPU private cloud in een colocatiedatacenterGPU private cloud op uw eigen locatieHybride
Hoe u betaaltPer token, per uur of per gebruiker, maandelijksHardware gekocht, gefinancierd of geleaset, plus rackruimte en stroomHardware gekocht, gefinancierd of geleaset; eigen stroom en koelingEen private basis plus gemeten cloud voor pieken
Het best alsIdeeën uitproberen, piekerige of korte workloadsStabiel AI-gebruik en u hebt geen geschikte serverruimteStabiel gebruik, strikte dataregels en een locatie met stroom en koelingStabiele basislast met af en toe grote pieken
Waar de data staatDe regio's van de providerEen Brits datacenter naar keuzeUw eigen gebouw, kan air-gapped zijnGevoelige data privé, de rest waar het het goedkoopst is
Tijd tot startMinutenWeken tot maanden: levertijden van hardware en installatieWeken tot maanden, langer als de locatie aanpassingen aan stroom of koeling nodig heeftStart in de cloud en verhuis stabiel werk zodra de hardware binnenkomt
Kosten naarmate het gebruik groeitStijgen met elke gebruiker en elke aanroepVlak totdat u meer GPU's nodig hebtVlak totdat u meer GPU's nodig hebtVlakke basis, gemeten pieken
Latentie naar uw systemenVia het internet of een private verbindingLaag, met een private verbinding naar uw locatiesLaagst, op uw eigen netwerkLaag voor private workloads
Keuze in modellen en toolsDe catalogus en limieten van de providerAlles wat u kunt draaienAlles wat u kunt draaienBeide
Benodigde vaardighedenCloud- en applicatievaardighedenPlatform- en GPU-beheer, of een managed servicePlatform-, GPU- en facilitair beheer, of een managed serviceBeide, plus plaatsing van workloads
GPU-beschikbaarheidNieuwste GPU's vaak uitverkocht of gerantsoeneerdGegarandeerd na installatieGegarandeerd na installatieGegarandeerde basis, pieken op best-effortbasis
HardwarevernieuwingDe keuze van de providerUw keuze, elke 3 tot 5 jaar; oudere GPU's schuiven door naar lichter werkUw keuze, elke 3 tot 5 jaarUw keuze voor de basis

Terug naar inhoud

Een GPU private cloud vanaf nul bouwen

De acht fasen die we met elke private cloud doorlopen, van de eerste workshop tot een platform dat uw teams elke dag gebruiken.

  1. 1

    Workloads en dimensionering

    Maak een lijst van de assistenten, agents, zoekopdrachten en trainingsjobs die u wilt draaien, en van de modellen, gebruikers en data. Wij vertalen dat naar GPU's, VRAM, opslag en netwerk.

    U beslist: Welke workloads eerst komen en hoe succes eruitziet

  2. 2

    Locatie

    Uw eigen serverruimte, uw datacenter of een Britse colocatiehal. We onderzoeken stroom, koeling, vloerbelasting en connectiviteit, of vinden colocatieruimte die voor GPU-racks is gebouwd.

    U beslist: On-premises of colocatie

  3. 3

    Hardwareontwerp

    GPU-servers (NVIDIA of AMD, Dell of NVIDIA DGX), CPU-nodes, opslaglagen, compute-fabric en beheernetwerk, met reserveonderdelen en ruimte om te groeien.

    U beslist: GPU-familie, leverancier en hoeveel groei u inbouwt

  4. 4

    Financiering

    Direct kopen, de kosten spreiden met een financial lease of huurkoop, of tijdelijk capaciteit leasen totdat uw eigen hardware binnen is.

    U beslist: Investering, financial lease of geleasede capaciteit

  5. 5

    Bouw en burn-in

    Levering, plaatsing in racks, bekabeling en opstarten, gevolgd door firmwarebaselines, fabrictests, opslagbenchmarks en een meerdaagse burn-in van elke GPU.

    U beslist: Acceptatietests en data

  6. 6

    Platform

    Kubernetes en de GPU-operators, schedulers, GPU-deling, imageregistry, identiteit, secrets en monitoring, alles als code zodat het opnieuw kan worden opgebouwd.

    U beslist: Kubernetes, Slurm of beide

  7. 7

    AI-diensten

    Model serving, de modelcatalogus, een assistent voor medewerkers, RAG over uw documenten, notebooks en fine-tuning, gekoppeld aan uw systemen.

    U beslist: Goedgekeurde modellen en welke data elke dienst mag gebruiken

  8. 8

    Overdracht en beheer

    Runbooks, training voor uw team, kosten- en gebruiksrapportage, en uw eigen beheer of onze managed service.

    U beslist: Wie het dagelijks beheert

Terug naar inhoud

Probeer het: het private AI-cloudlab

Vier manieren om de opties voor uw eigen AI-workloads te verkennen. Niets wat u invoert verlaat uw browser, tenzij u ervoor kiest het naar ons te sturen.

Zes vragen, één per halte. Aan het eind krijgt u een startontwerp: hardware, VRAM, opslag, netwerk, stroom en het platform, plus waar u daarna heen kunt.

1Workload2Schaal3Modellen4Data5Locatie6Betalen

1 of 6

Wat gaat er als eerste op draaien?

Terug naar inhoud

Veelgestelde vragen over een GPU private cloud

Hoe klein kan een GPU private cloud zijn?
Eén PCIe-server met een paar RTX PRO 6000 GPU's, met hetzelfde platform als een groot cluster, is een echte private cloud. Veel klanten beginnen daar, of met DGX Spark voor ontwikkeling, en voegen servers toe naarmate het gebruik groeit.
NVIDIA of AMD?
Beide werken. NVIDIA heeft de breedste softwareondersteuning en de meeste kant-en-klare AI-services. AMD Instinct biedt veel geheugen per GPU, wat goed past bij inference van grote modellen, en draait de belangrijkste opensourceframeworks op ROCm. We dimensioneren beide en adviseren wat past bij uw modellen en team.
Kunnen we opensourcemodellen gebruiken?
Ja. Open-weight-modellen draaien op vLLM, SGLang en vergelijkbare servers, naast commerciële modellen en uw eigen gefinetunede modellen. We helpen u modellen te kiezen en een goedgekeurde catalogus in te richten.
Moet het op onze eigen locatie staan?
Nee. Veel private clouds draaien in een colocatie-datacenter in het VK met de stroom en koeling die GPU-racks nodig hebben, privé verbonden met uw locaties. De hardware blijft voor u alleen.
Hoe lang duurt het?
Een private cloud voor de start kan binnen enkele weken na levering van de hardware draaien. Grotere clusters hangen af van levertijden van GPU's en werkzaamheden op locatie; we geven u in de ontwerpfase een gedateerde planning en kunnen in de tussentijd capaciteit verhuren.
Kunt u het voor ons beheren?
Ja. We kunnen het hele platform als managed service beheren, of het bouwen, uw team trainen en ondersteunen.
Hoe betalen we ervoor?
Direct kopen, de kosten spreiden met een financial lease of lease-to-own, of maandelijks capaciteit huren. Zie GPU-leasing voor de opties.

Gerelateerde pagina's

AI-datacenters · GPU-clusters · GPU-leasing · Private AI · AI Factory · MLOps-opzet

Terug naar inhoud

Plan uw GPU private cloud

Vertel ons de workloads, gebruikers en dataregels, of stuur uw antwoorden uit het bouwtraject, en we komen terug met een ontwerp, een gedateerde planning en de kosten van kopen, financieren of huren.

Praat met ons over een private cloudBekijk GPU-servers