AI-kennisbank · Linux-besturingssysteem
Linux, getuned voor AI
Elk AI-systeem dat we leveren draait op Linux. Deze gids behandelt de distributies die het Workstation-team ondersteunt, hoe we ze hardenen, de kernel- en driverinstellingen die ertoe doen voor GPU's, hoe we ze draaien onder Kubernetes en Docker, hoe LLM-API's daarop schalen en de CI/CD-pipelines die modellen, agents en data veilig naar productie brengen.
- Ubuntu
- Red Hat Enterprise Linux
- SUSE Linux
- Alpine Linux
- Debian
- Rocky & AlmaLinux
Een distributie kiezen
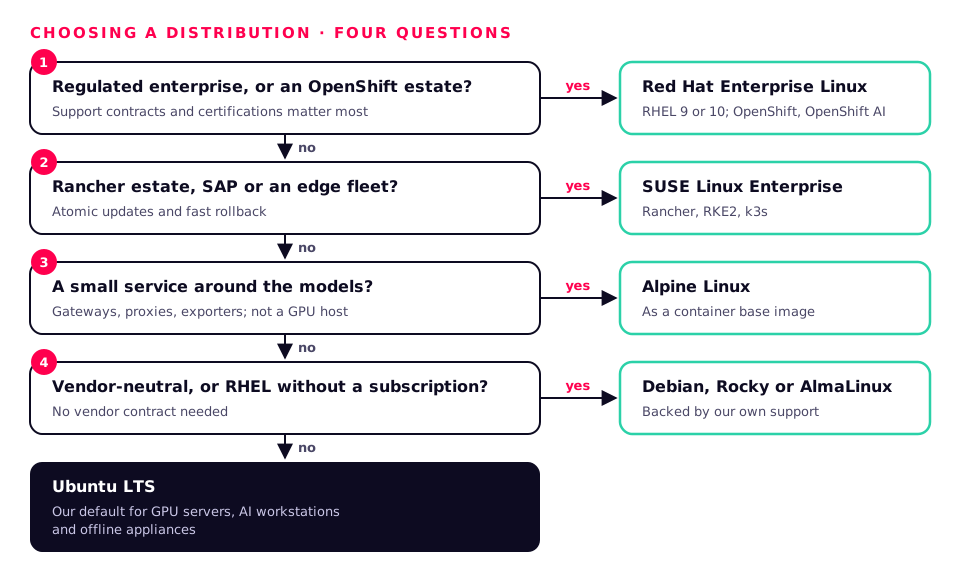
Er is niet één beste Linux voor AI. De juiste keuze hangt af van waar het draait, wie het ondersteunt en waar het verder in moet passen. Zo beslissen we meestal.
| Distributie | Het meest geschikt voor | GPU & CUDA | Kubernetes | Levenscyclus |
|---|---|---|---|---|
| Ubuntu LTS | GPU-servers, workstations, de meeste AI-teams | Eersteklas: NVIDIA bouwt en test hier als eerste; ondertekende drivers | Canonical Kubernetes, MicroK8s, k3s, RKE2 | 5 jaar, 10+ met Ubuntu Pro |
| Red Hat Enterprise Linux | Gereguleerde ondernemingen, OpenShift-omgevingen | NVIDIA CUDA-repository en driverstreams; RHEL AI | OpenShift, OpenShift AI | 10 jaar, plus uitgebreide ondersteuning |
| SUSE Linux Enterprise | Rancher-omgevingen, SAP en edge-vloten | Ondertekende pakketten van de open NVIDIA-kerneldriver; SUSE AI | Rancher, RKE2, k3s | Lange levenscyclus met LTSS |
| Alpine Linux | Minimale containers, gateways en edge-services | Niet voor GPU-hosts (musl, geen CUDA) | Als container-base-image | Ongeveer 2 jaar per release |
| Debian | Stabiele, leveranciersonafhankelijke servers en labs | NVIDIA-drivers in non-free; CUDA-repository | k3s, kubeadm, RKE2 | Ongeveer 5 jaar met LTS |
| Rocky & AlmaLinux | RHEL-compatibel zonder abonnement | Dezelfde pakketten als RHEL | kubeadm, RKE2, k3s, OKD | Ongeveer 10 jaar |
De distributies die we ondersteunen
Ubuntu
De standaard voor GPU-servers en AI-workstations.
Het grootste deel van het AI-ecosysteem wordt eerst op Ubuntu gebouwd en getest. De NGC-containers van NVIDIA, de CUDA-documentatie en veel framework-installers gaan ervan uit, wat minder verrassingen betekent wanneer een nieuwe GPU, driver of modelrelease verschijnt.
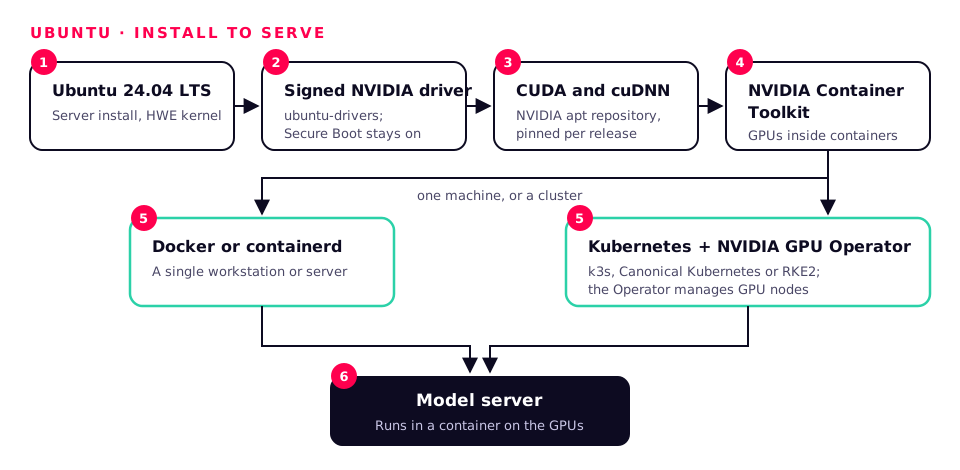
Versies die we uitrollen: Ubuntu 24.04 LTS (Server en Desktop), 22.04 LTS voor bestaande omgevingen
GPU-, CUDA- en AI-stack
- ubuntu-drivers installeert door Canonical ondertekende NVIDIA-kernelmodules, zodat UEFI Secure Boot ingeschakeld blijft zonder dat u een eigen sleutel hoeft te registreren.
- CUDA, cuDNN en de NVIDIA Container Toolkit uit de apt-repository's van NVIDIA, per release vastgepind.
- HWE-kernels brengen ondersteuning voor de nieuwste CPU's, GPU's en NIC's naar een LTS-release.
Hoe we het tunen voor AI
- Serverinstallaties, minimale pakketten, snaps op appliances vastgehouden of verwijderd.
- Performance-CPU-governor, NUMA-bewuste plaatsing en persistence mode voor de GPU's (zie de kernelsectie).
- Automatische beveiligingsupdates gepland in een onderhoudsvenster, of offline updatebundels voor air-gapped locaties.
Kubernetes en containers
- Docker of containerd met de NVIDIA Container Toolkit.
- k3s voor single-node en edge, Canonical Kubernetes of RKE2 voor clusters, met de NVIDIA GPU Operator erbovenop.
Beveiliging
- Ubuntu Pro voegt Livepatch, FIPS 140-modules, uitgebreid beveiligingsonderhoud en de Ubuntu Security Guide voor CIS- en DISA-STIG-hardening toe.
- AppArmor in enforcing-modus, met profielen voor de services die we draaien.
Onze visie: Onze standaard voor GPU-servers, AI-workstations en offline appliances, tenzij een omgeving al op iets anders is gestandaardiseerd.
Red Hat Enterprise Linux
Voor gereguleerde ondernemingen en OpenShift-omgevingen.
RHEL biedt een levenscyclus van tien jaar, gecertificeerde hardware en een supportcontract dat inkoop en auditors herkennen. Het AI-portfolio van Red Hat – RHEL AI, OpenShift AI en de op vLLM gebaseerde Red Hat AI Inference Server – bouwt erop voort.
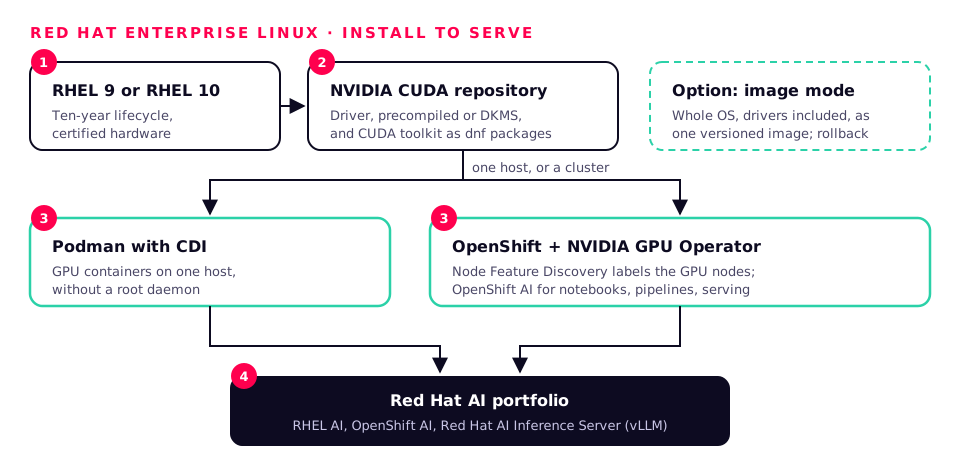
Versies die we uitrollen: RHEL 9 en RHEL 10
GPU-, CUDA- en AI-stack
- De CUDA-repository van NVIDIA voor RHEL levert de driver (voorgecompileerd of DKMS) en de CUDA-toolkit als dnf-pakketten.
- Podman met CDI (Container Device Interface) voor GPU-containers zonder root-daemon.
- Met image mode (opstartbare containers) kan het hele OS, inclusief drivers, als één geversioneerde image worden uitgerold en teruggedraaid.
Hoe we het tunen voor AI
- tuned-profielen zoals throughput-performance of accelerator-performance als startpunt, daarna aanpassingen per workload.
- NUMA-, IRQ-affiniteit- en huge-page-instellingen beheerd als code.
Kubernetes en containers
- OpenShift met de NVIDIA GPU Operator en Node Feature Discovery; OpenShift AI voor notebooks, pipelines en model serving.
Beveiliging
- SELinux standaard in enforcing-modus, FIPS-modus en OpenSCAP met de SCAP Security Guide voor CIS- en STIG-profielen.
- kpatch live kernel patching voor beveiligingsfixes zonder downtime.
Onze visie: De juiste keuze wanneer supportcontracten, certificeringen of een bestaand OpenShift-platform belangrijker zijn dan de nieuwste pakketten.
SUSE Linux
Voor door Rancher beheerde vloten, SAP en de edge.
SUSE combineert een enterprise-Linux met Rancher, een van de meestgebruikte manieren om veel Kubernetes-clusters te beheren, en met SUSE AI voor het draaien van private AI op dat platform. Dankzij de snapshot- en transactional-update-tooling worden rollbacks routine.
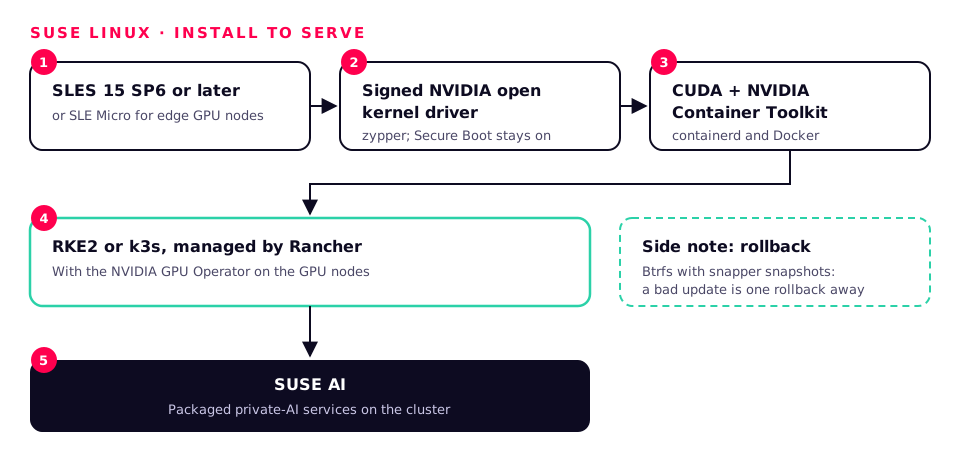
Versies die we uitrollen: SUSE Linux Enterprise Server 15 SP6 en later, SLE Micro voor edge, openSUSE Leap voor labs
GPU-, CUDA- en AI-stack
- SUSE verpakt de open GPU-kernelmodules van NVIDIA, ondertekend voor Secure Boot en installeerbaar met zypper.
- CUDA uit de SUSE-repository van NVIDIA; de NVIDIA Container Toolkit voor containerd en Docker.
Hoe we het tunen voor AI
- Btrfs met snapper-snapshots, zodat een slechte driver- of kernelupdate maar één rollback verwijderd is.
- Het alleen-lezen, transactionele OS van SLE Micro voor edge-GPU-nodes die atomair moeten updaten.
Kubernetes en containers
- RKE2 of k3s beheerd door Rancher, met de NVIDIA GPU Operator; SUSE AI voor kant-en-klare private-AI-services.
Beveiliging
- Mandatory access control (AppArmor of SELinux), FIPS-gecertificeerde modules, OpenSCAP-hardeningprofielen.
- SUSE Live Patching voor kernelfixes zonder herstart.
Onze visie: Het best wanneer Rancher de clusters al beheert, of voor edge-vloten die atomaire updates en snelle rollback nodig hebben.

Alpine Linux
Klein, snel en gehard, voor containers in plaats van GPU-hosts.
De base-image van Alpine is maar een paar megabyte groot, gebouwd op musl libc en BusyBox met een geharde toolchain. Dat maakt hem uitstekend voor de kleine services rond een AI-systeem, en ongeschikt voor het GPU-werk zelf.
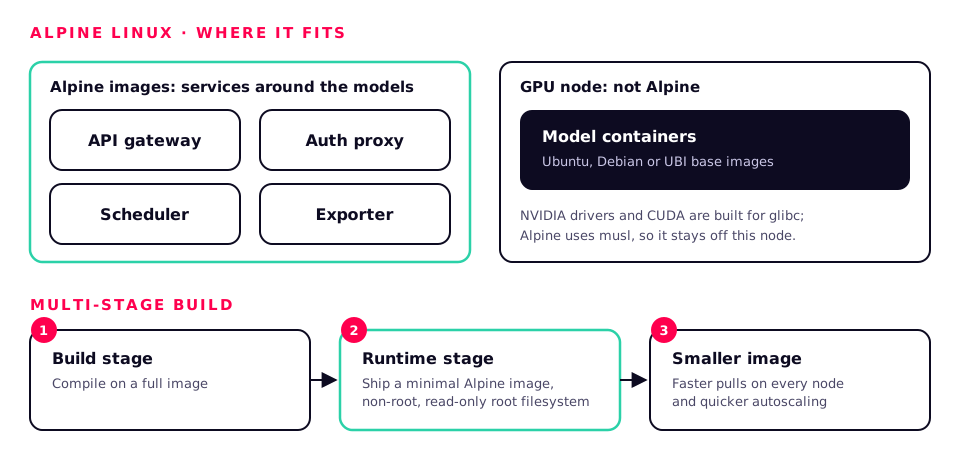
Versies die we uitrollen: Actuele stabiele Alpine-releases, als container-base-images
GPU-, CUDA- en AI-stack
- NVIDIA-drivers en CUDA zijn gebouwd voor glibc en PyTorch publiceert geen musl-wheels, dus GPU-images en de meeste trainingsimages horen op een Ubuntu-, Debian- of UBI-basis.
- Ideaal voor API-gateways, auth-proxy's, schedulers, exporters en lichte CPU-inferentie met gecompileerde runtimes.
Hoe we het tunen voor AI
- Multi-stage builds die compileren op een volledige image en een minimale Alpine-runtime leveren.
- Kleinere images betekenen snellere pulls op elke node en sneller autoscaling.
Kubernetes en containers
- Een base-image voor sidecars, init-containers en edge-services in elke Kubernetes-distributie.
Beveiliging
- Een kleine pakketset betekent een klein aanvalsoppervlak en korte rapporten van kwetsbaarheidsscans.
- Draai als non-root met een alleen-lezen root-bestandssysteem.
Onze visie: Gebruik het voor de services rond uw modellen, niet voor de GPU-nodes of de modelcontainers zelf.

Debian, Rocky & AlmaLinux
Communitydistributies die we in productie ondersteunen.
Debian is de stabiele, leveranciersonafhankelijke basis onder Ubuntu en veel appliances. Rocky Linux en AlmaLinux zijn binair compatibel met RHEL, voor teams die het RHEL-ecosysteem willen zonder abonnement.
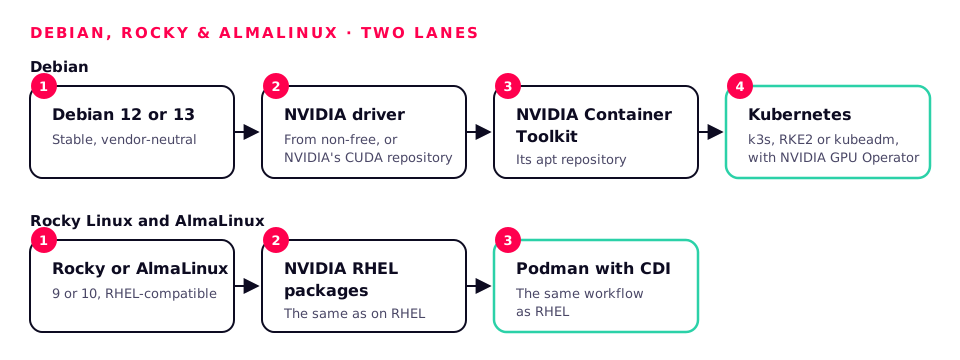
Versies die we uitrollen: Debian 12 en 13; Rocky Linux en AlmaLinux 9 en 10
GPU-, CUDA- en AI-stack
- Debian: NVIDIA-drivers uit de non-free-repository of de CUDA-repository van NVIDIA; de apt-repository van de NVIDIA Container Toolkit.
- Rocky en AlmaLinux: dezelfde NVIDIA-RHEL-pakketten en dezelfde Podman-CDI-workflow als RHEL.
Hoe we het tunen voor AI
- Dezelfde kernel-, NUMA- en opslaginstellingen als hun commerciële verwanten, toegepast met Ansible.
- Debian vormt ook de basis van Proxmox VE, dat we gebruiken voor GPU-passthroughlabs.
Kubernetes en containers
- k3s-, RKE2- of kubeadm-clusters met de NVIDIA GPU Operator.
Beveiliging
- CIS-benchmarks via OpenSCAP, AppArmor op Debian en SELinux op Rocky en AlmaLinux, met geautomatiseerde beveiligingsupdates.
Onze visie: Solide, kosteneffectieve keuzes wanneer u geen leverancierscontract nodig hebt, ondersteund door onze eigen support.
Kernel- & OS-optimalisaties voor AI-workloads
GPU's zijn alleen snel als de host ze voldoende voedt. Dit zijn de instellingen die we op elk AI-systeem controleren en daarna afstemmen op de eigen workload van de klant. Geen enkele is universeel: we meten vooraf en achteraf.
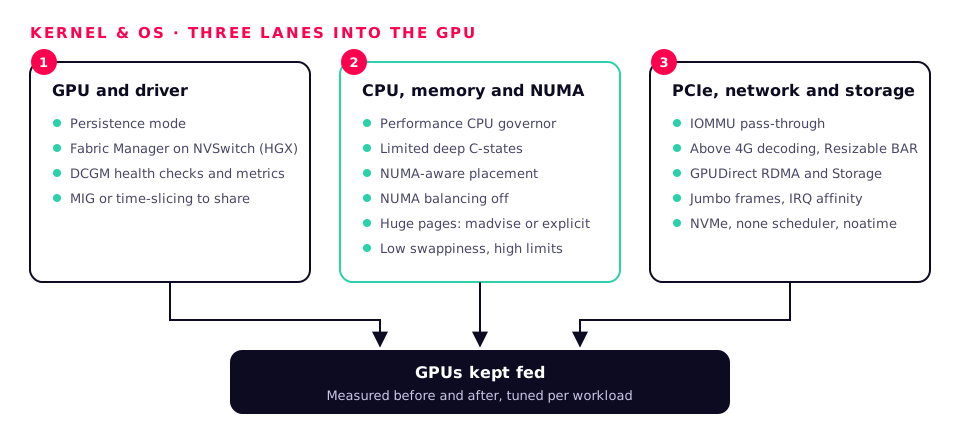
GPU en driver
- Persistence mode (nvidia-persistenced) zodat de driver geladen blijft en het eerste verzoek niet traag is.
- NVIDIA Fabric Manager op NVSwitch-systemen (HGX): zonder deze initialiseren de GPU's niet voor CUDA.
- DCGM voor health checks, diagnostiek en metrics per GPU.
- MIG-partities of time-slicing wanneer veel kleine modellen één grote GPU delen.
CPU, geheugen en NUMA
- Performance-CPU-governor en beperkte diepe C-states op latentiegevoelige inferentiehosts.
- NUMA-bewuste plaatsing: het werk van elke GPU wordt vastgepind aan de dichtstbijzijnde CPU-socket en het dichtstbijzijnde geheugen (nvidia-smi topo -m toont de kaart).
- Automatische NUMA-balancing uitgeschakeld op dedicated GPU-hosts, zodat pagina's niet migreren onder belasting.
- Transparent huge pages standaard op madvise; expliciete huge pages voor RDMA- en DPDK-workloads.
- Lage swappiness en ruime memlock- en file-descriptorlimieten voor dataloaders en RDMA.
PCIe, netwerk en opslag
- IOMMU in pass-throughmodus en Above 4G decoding / Resizable BAR in de firmware.
- GPUDirect RDMA (nvidia-peermem) en GPUDirect Storage (nvidia-fs) zodat data de CPU overslaat.
- Jumboframes end-to-end op opslag- en RoCE-fabrics, met IRQ-affiniteit verdeeld over de cores.
- NVMe met de scheduler none, XFS of ext4 met noatime voor datasets en checkpoints.
Een startpunt (per workload getest, nooit blind gekopieerd)
# /etc/sysctl.d/90-ai.conf
kernel.numa_balancing = 0
vm.swappiness = 10
vm.max_map_count = 1048576
net.core.rmem_max = 268435456
net.core.wmem_max = 268435456

# kernel command line (GRUB)
iommu=pt transparent_hugepage=madvise

# services
systemctl enable --now nvidia-persistenced
systemctl enable --now nvidia-fabricmanager   # NVSwitch (HGX) systems
cpupower frequency-set -g performance
Kubernetes & Docker voor AI
De meeste AI-systemen die we bouwen draaien in containers, van één workstation met Docker tot GPU-clusters met meerdere nodes. De bouwstenen zijn op elke distributie hetzelfde.
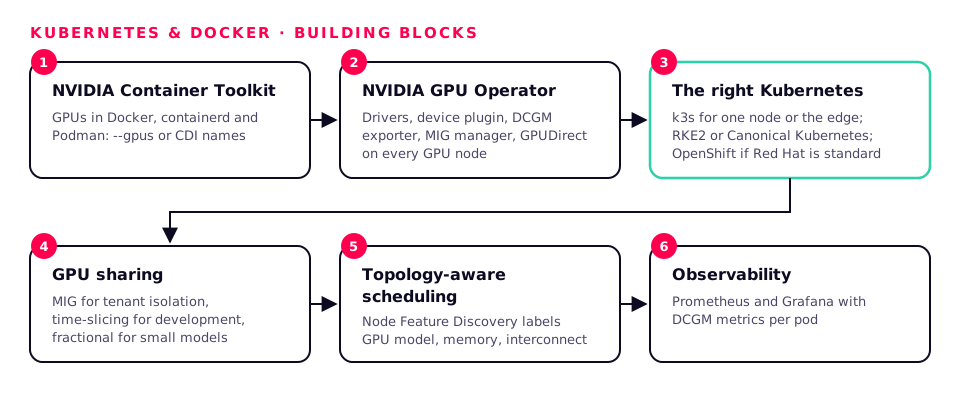
NVIDIA Container Toolkit
Geeft Docker, containerd en Podman toegang tot de GPU's, via de vlag --gpus of CDI-apparaatnamen.
NVIDIA GPU Operator
Installeert en beheert drivers, de device plugin, DCGM-exporter, MIG-manager en GPUDirect-componenten op elke Kubernetes-GPU-node.
De juiste Kubernetes
k3s voor één node of de edge, RKE2 of Canonical Kubernetes voor clusters, OpenShift waar Red Hat de standaard is.
GPU-sharing
MIG voor strikte isolatie tussen tenants, time-slicing voor ontwikkeling en fractionele scheduling voor veel kleine modellen.
Topologiebewuste scheduling
Node Feature Discovery labelt GPU-model, geheugen en interconnect, zodat grote jobs op de nodes terechtkomen die daarbij passen.
Observability
Prometheus en Grafana met DCGM-metrics: GPU-gebruik, geheugen, temperatuur, stroomverbruik en fouten per pod.
Native LLM-API's en hoe ze schalen
We serveren modellen achter OpenAI-compatibele API's, zodat het applicaties niet uitmaakt welk model of welke engine erachter zit. Schalen gebeurt dan in vier richtingen.
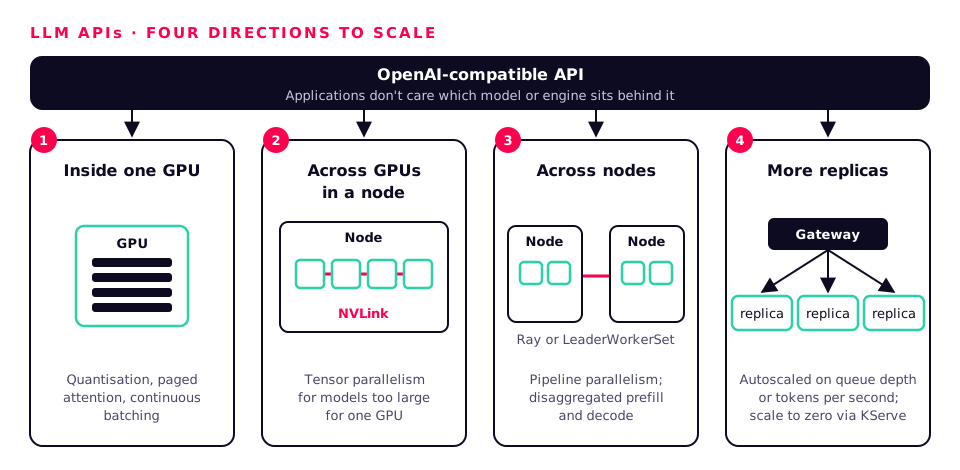
- 1
Binnen één GPU
Kwantisatie (FP8, NVFP4 op Blackwell, AWQ), paged attention en continuous batching in vLLM, SGLang of TensorRT-LLM passen meer gebruikers op elke GPU.
- 2
Over GPU's in een node
Tensorparallellisme via NVLink serveert modellen die te groot zijn voor één GPU, met de laagste latency.
- 3
Over nodes heen
Pipelineparallellisme met Ray of Kubernetes LeaderWorkerSet voor de grootste modellen, en gedisaggregeerde prefill en decode (NVIDIA Dynamo, llm-d) op clusterschaal.
- 4
Meer replica's
Horizontaal schalen achter een gateway, automatisch geschaald op wachtrijdiepte of tokens per seconde met KEDA of de HPA, met KV-cache-bewuste routering en scale-to-zero via KServe.
Engines die we inzetten: vLLM, SGLang, TensorRT-LLM met Triton Inference Server, NVIDIA NIM, en Ollama of llama.cpp voor systemen naast het bureau en aan de edge. Veel LoRA-adapters kunnen één basismodel op dezelfde GPU's delen.
CI/CD voor LLM's, agents en datapipelines
AI verandert vaker dan gewone software: nieuwe modelversies, nieuwe prompts, nieuwe data. We geven elk van de drie een eigen pipeline, met dezelfde discipline: alles geversioneerd, getest, ondertekend en via ringen gepromoveerd.
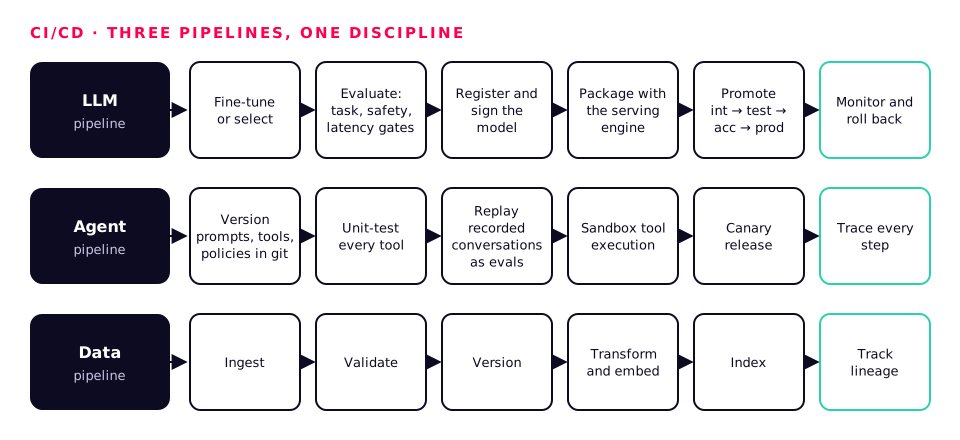
LLM-pipeline
- Finetunen of selecteren
- Evalueren tegen taak-, veiligheids- en latency-gates
- Model registreren en ondertekenen
- Verpakken met de serving-engine
- Promoveren int → test → acc → prod
- Monitoren en terugdraaien
Kubeflow of Ray voor training, MLflow-registry, cosign-handtekeningen, Argo CD voor GitOps en Ring Promoter voor releases ring voor ring met health checks.
Agentpipeline
- Prompts, tools en policies versioneren in git
- Elke tool unit-testen
- Opgenomen gesprekken afspelen als evals
- Tooluitvoering in een sandbox
- Canary-release
- Elke stap tracen
Gecontaineriseerde toolsandboxes, evaluatiesuites in CI, OpenTelemetry-tracing, kosten- en ratebudgetten per agent.
Datapipeline
- Inlezen
- Valideren
- Versioneren
- Transformeren en embedden
- Indexeren
- Lineage bijhouden
Airflow, Dagster of Argo Workflows; Great Expectations voor validatie; lakeFS of DVC voor versies; Spark of Ray voor schaal; pgvector, Qdrant of Milvus voor retrieval; OpenLineage voor lineage.
CI draait op self-hosted runners binnen uw netwerk, inclusief GPU-runners voor evaluatie, zodat modellen en data het nooit verlaten.
Hoe we Linux beveiligen voor AI
Een AI-server bevat uw meest waardevolle data en een deel van uw duurste hardware. We beveiligen hem in lagen, zodat geen enkele fout een van beide blootlegt.
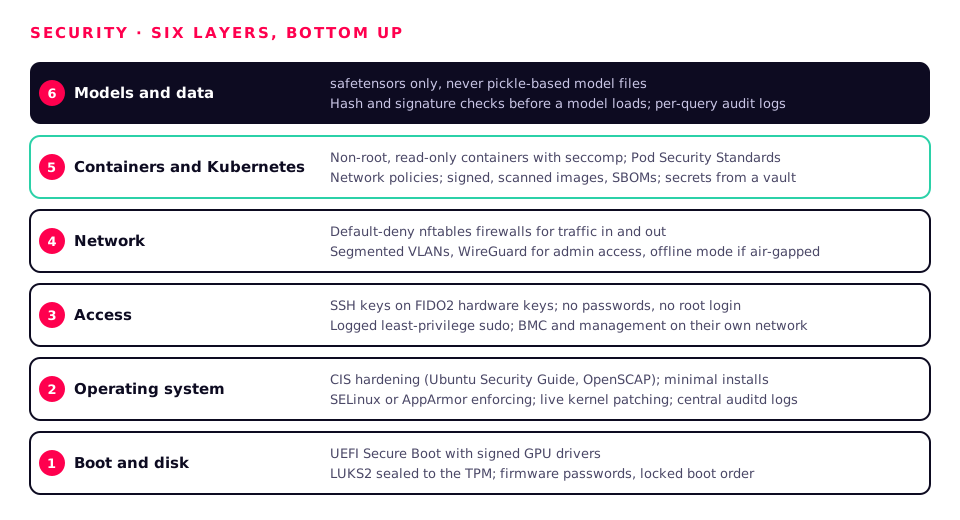
01
Boot en schijf
- UEFI Secure Boot met ondertekende GPU-drivers
- Volledige schijfversleuteling (LUKS2) verzegeld aan de TPM, met onbeheerde herstart
- Firmwarewachtwoorden en vergrendelde opstartvolgorde
02
Besturingssysteem
- Hardening volgens de CIS-benchmark (Ubuntu Security Guide, OpenSCAP)
- SELinux of AppArmor in enforcing-modus
- Minimale installaties en live kernelpatching
- auditd-logging naar een centrale opslag
03
Toegang
- SSH-sleutels op FIDO2-hardwaresleutels, geen wachtwoorden, geen root-login
- sudo met minimale rechten en logging
- BMC en beheer op een eigen netwerk
04
Netwerk
- Default-deny firewalls (nftables) voor inkomend en uitgaand verkeer
- Gesegmenteerde VLAN's en WireGuard voor beheertoegang
- Volledig offline modus voor air-gapped locaties
05
Containers en Kubernetes
- Non-root, read-only containers met seccomp-profielen
- Pod Security Standards en netwerkpolicies
- Ondertekende images, kwetsbaarheidsscans en SBOM's
- Secrets uit een vault, nooit in images of git
06
Modellen en data
- Alleen safetensors, nooit op pickle gebaseerde modelbestanden
- Hash- en handtekeningcontroles voordat een model laadt
- Auditlogs per query en toegang op dossier- of tenantniveau
Ondersteund door het Workstation-team
Kies de distributie die bij uw organisatie past en wij leveren hem klaar voor AI-werk, en houden hem zo.
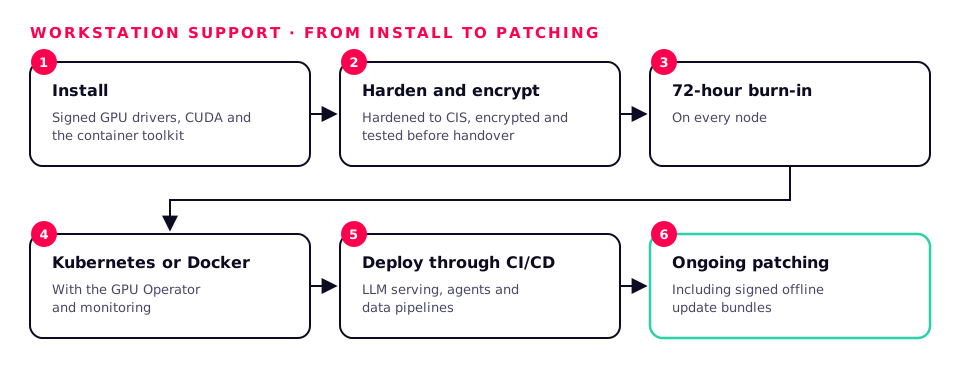
- Geïnstalleerd met ondertekende GPU-drivers, CUDA en de container toolkit
- Gehard volgens CIS, versleuteld en getest vóór overdracht
- Burn-in van 72 uur op elke node
- Kubernetes of Docker ingericht, met de GPU Operator en monitoring
- LLM-serving, agents en datapipelines uitgerold via CI/CD
- Doorlopend patchen, inclusief ondertekende offline updatebundels
Logo's zijn handelsmerken van hun respectieve eigenaren en worden alleen gebruikt om de producten te identificeren die we ondersteunen. De logo's van Debian, Rocky Linux en AlmaLinux worden gebruikt onder CC BY-SA-licenties van Wikimedia Commons.