AI-kennisbank · AI-cloudplatformen
Elke AI-cloud, één team dat ze kent
Hyperscalers voor beheerde modellen en enterprise-controles, GPU-clouds voor pure capaciteit, marktplaatsen voor de goedkoopste uren. Het Workstation-team ontwerpt, beveiligt en beheert AI op al deze platformen, en naast de hardware die u zelf bezit.
Hyperscalers
Amazon Web Services
Amazon Bedrock, SageMaker AI en het breedste aanbod aan GPU's en eigen chips.
Lees de gids →
Google Cloud
Vertex AI, Gemini en TPU's naast NVIDIA GPU's.
Lees de gids →
Microsoft Azure
Azure OpenAI en AI Foundry, gekoppeld aan Microsoft 365 en Entra ID.
Lees de gids →
Oracle Cloud Infrastructure
Bare-metal GPU-superclusters en OCI Generative AI.
Lees de gids →GPU-clouds
CoreWeave
Een Kubernetes-native cloud gebouwd voor grote GPU-clusters.
Lees de gids →Lambda
Eenvoudige, snelle GPU-instances en -clusters voor AI-teams.
Lees de gids →Nebius
Een full-stack AI-cloud met GPU-clusters en beheerde inferentie.
Lees de gids →
DigitalOcean
Ontwikkelaarsvriendelijke GPU Droplets en een agentplatform.
Lees de gids →GPU-marktplaatsen
Ook ondersteund: Together AI, Fireworks AI, Groq, Hugging Face Inference Endpoints, Replicate, Crusoe, Hyperstack, Scaleway en OVHcloud.
Hoe ze zich verhouden
De meeste organisaties gebruiken er meer dan één: een hyperscaler voor beheerde modellen en governance, een GPU-cloud voor training of zware inferentie, en eigen hardware voor gevoelige of constante workloads.
| Type | Sterke punten | Afwegingen | Gebruik het voor |
|---|---|---|---|
| Hyperscalers (AWS, Google Cloud, Azure, Oracle) | Beheerde modellen, identiteit, compliance, wereldwijde regio's | Hogere GPU-prijzen, quota om te beheren | Productie-API's, gereguleerde data, beheerde agents |
| GPU-clouds (CoreWeave, Lambda, Nebius, DigitalOcean) | Nieuwste GPU's, grote clusters, eenvoudigere prijzen | Minder beheerde diensten | Training, fine-tuning, inferentie met hoog volume |
| GPU-marktplaatsen (Vast.ai, RunPod) | Laagste kosten per GPU-uur, snel van start | Wisselende betrouwbaarheid en vertrouwen | Experimenten, batchjobs, endpoints die naar nul schalen |
| Uw eigen Workstation-hardware | Vaste kosten, volledige controle, data blijft in uw gebouw | Kapitaalinvestering, capaciteitsplanning | Gevoelige data, constante workloads, ontwikkeling |
AI op grote schaal schalen met Amazon Bedrock
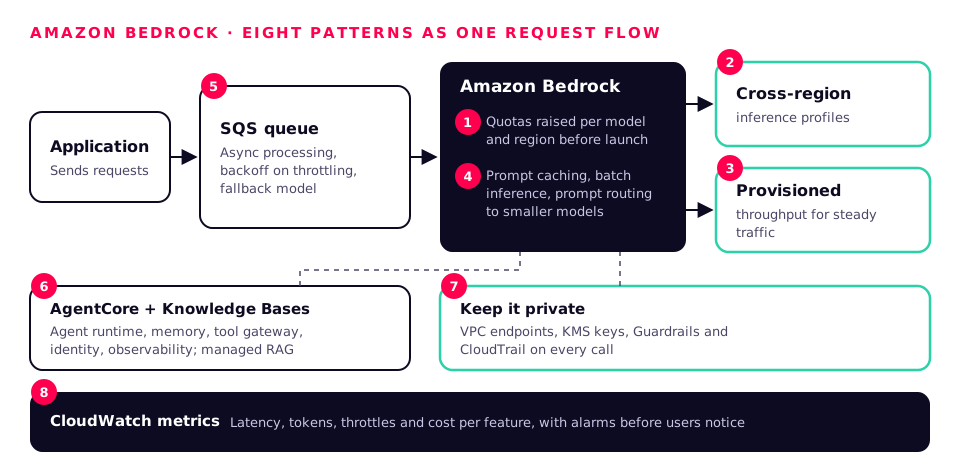
Bedrock neemt het GPU-probleem weg, maar verkeer op grote schaal moet nog steeds worden ontworpen. Dit zijn de patronen die we gebruiken voor Bedrock-workloads met hoog volume.
- 1
Plan eerst de quota
Modelleer tokens per minuut en verzoeken per minuut tegen piekverkeer en verhoog quota vóór de lancering, per model en per regio.
- 2
Spreid de belasting
Cross-region inferentieprofielen routeren verzoeken automatisch over regio's wanneer er één druk is.
- 3
Garandeer capaciteit
Provisioned throughput voor constant, latencygevoelig verkeer; on-demand voor de rest.
- 4
Verlaag de kosten per verzoek
Promptcaching voor herhaalde context, batchinferentie voor offline werk en promptroutering om eenvoudige verzoeken naar kleinere modellen te sturen.
- 5
Vang pieken op
Zet verzoeken in een wachtrij (SQS) en verwerk ze asynchroon, met exponentiële backoff bij throttling en een fallbackmodel.
- 6
Draai agents op de juiste manier
Bedrock AgentCore voor agentruntime, geheugen, toolgateway, identiteit en observability; Knowledge Bases voor beheerde RAG.
- 7
Houd het privé
VPC-endpoints, KMS-sleutels, Guardrails en CloudTrail bij elke aanroep.
- 8
Meet alles
CloudWatch-metrics voor latency, tokens, throttles en kosten per functie, met alarmen voordat gebruikers iets merken.
CI/CD voor LLM's, agents en data in de cloud
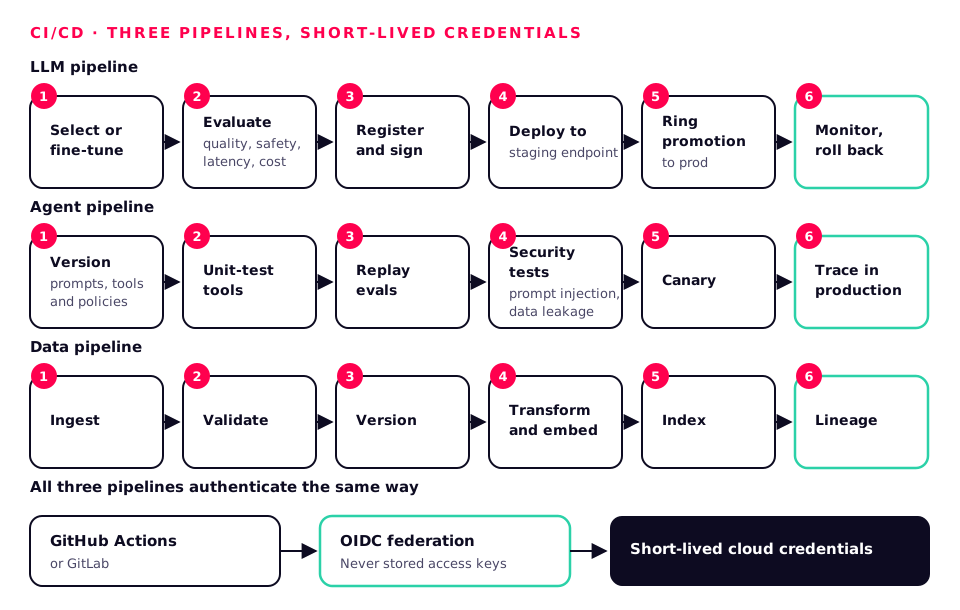
Dezelfde discipline als on-premises: alles geversioneerd, getest, ondertekend en via ringen gepromoveerd, met infrastructure as code zodat elke omgeving reproduceerbaar is.
LLM-pipeline
- Selecteren of fine-tunen
- Evalueren (kwaliteit, veiligheid, latency, kosten)
- Registreren en ondertekenen
- Uitrollen naar staging-endpoint
- Ringpromotie naar productie
- Monitoren en terugdraaien
Evaluatie met Bedrock, Vertex AI of Azure AI Foundry; SageMaker- of Vertex-pipelines; MLflow-registry; Terraform of OpenTofu; Ring Promoter voor releases met healthchecks.
Agentpipeline
- Prompts, tools en beleid versioneren
- Tools unit-testen
- Evals herhalen
- Beveiligingstests (promptinjectie, datalekken)
- Canary
- Tracen in productie
AgentCore, Agent Engine of Foundry Agent Service; OpenTelemetry-tracing; evaluatiesuites in CI.
Datapipeline
- Inlezen
- Valideren
- Versioneren
- Transformeren en embedden
- Indexeren
- Lineage
AWS Glue, Dataflow of Data Factory; Airflow of Dagster; Bedrock Knowledge Bases, Vertex AI Search of Azure AI Search; OpenLineage.
Pipelines draaien met kortlevende cloudreferenties via OIDC-federatie vanuit GitHub Actions of GitLab, nooit met opgeslagen toegangssleutels.
LLM- en agent-API's beveiligen
Een LLM-endpoint is een API die je dingen kunt aanpraten. We beveiligen het zoals elke kritieke API en voegen daarna de AI-specifieke controles toe.
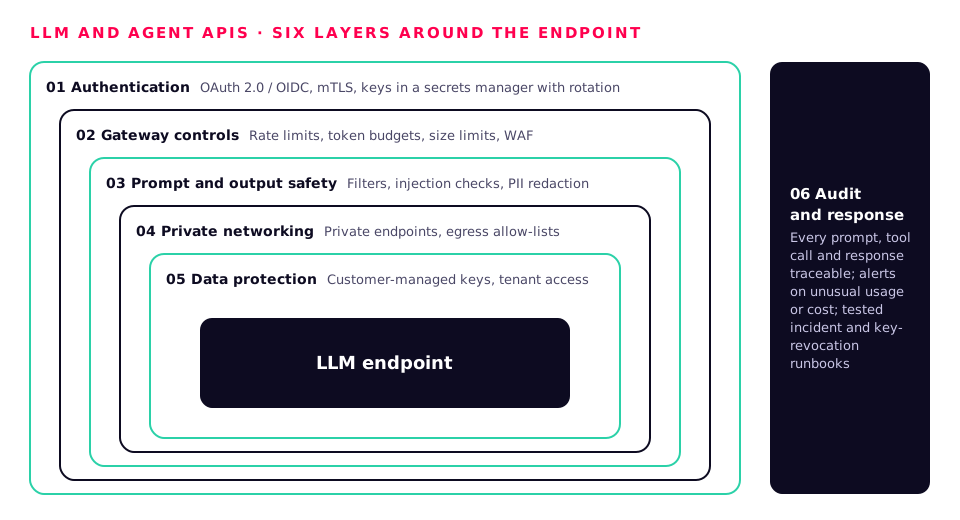
01
Authenticatie
- OAuth 2.0 / OIDC voor gebruikers en services
- mTLS tussen services
- Geen statische API-sleutels in code; sleutels in een secretsmanager met rotatie
02
Gatewaycontroles
- Rate limits en tokenbudgetten per gebruiker en tenant
- Limieten voor verzoekgrootte en context
- WAF vóór publieke endpoints
03
Prompt- en outputveiligheid
- Guardrails, Model Armor of Content Safety op input en output
- Detectie van promptinjectie in opgehaalde documenten en toolresultaten
- Redactie van persoonsgegevens vóór het loggen
04
Privénetwerken
- Private endpoints voor model-API's
- Egress-allowlists voor agents en tools
- Geen publieke IP's op modelservers
05
Gegevensbescherming
- Door de klant beheerde sleutels
- Toegang op tenant- en documentniveau bij retrieval
- Dataresidentie in VK- of EU-regio's waar vereist
06
Audit en respons
- Elke prompt, toolaanroep en elk antwoord herleidbaar
- Waarschuwingen bij ongebruikelijk gebruik of ongebruikelijke kosten
- Geteste runbooks voor incidenten en het intrekken van sleutels
Het AI-agentharnas
Een agent is een model plus een harnas: de code die bepaalt wat hij mag zien, welke tools hij mag aanroepen en wanneer een mens moet goedkeuren. In het harnas zitten veiligheid en betrouwbaarheid.
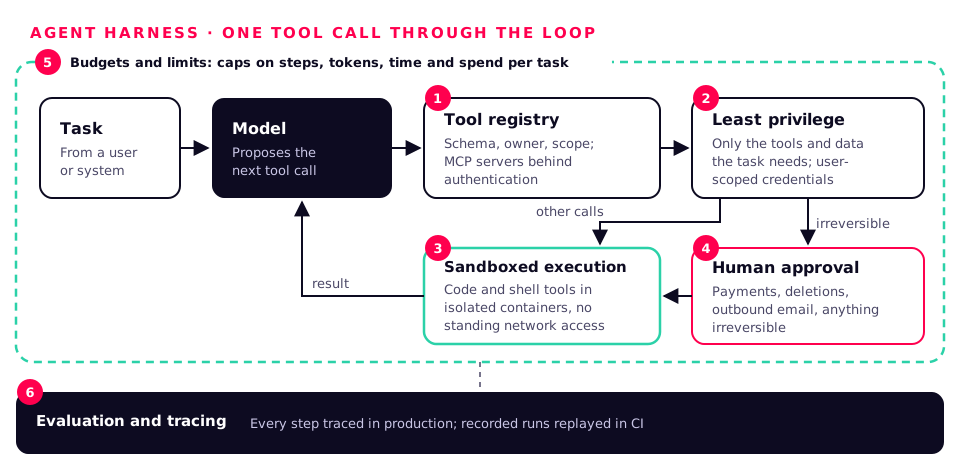
Toolregistry
Elke tool gedeclareerd met een schema, een eigenaar en een permissiescope; MCP-servers achter authenticatie.
Least privilege
Elke agent krijgt alleen de tools en data die zijn taak nodig heeft, met referenties beperkt tot de gebruiker namens wie hij handelt.
Uitvoering in een sandbox
Code- en shelltools draaien in geïsoleerde containers zonder permanente netwerktoegang.
Mens in de lus
Goedkeuringen voor betalingen, verwijderingen, uitgaande e-mails en alles wat onomkeerbaar is.
Budgetten en limieten
Maxima voor stappen, tokens, tijd en uitgaven per taak, met een nette afbreking wanneer ze worden bereikt.
Evaluatie en tracing
Opgenomen runs worden in CI opnieuw afgespeeld en elke stap wordt in productie getraced voor debugging en audit.
Identiteit en authenticatie voor AI
Agents handelen namens mensen en systemen, dus ze hebben echte identiteiten nodig, geen gedeelde sleutels.
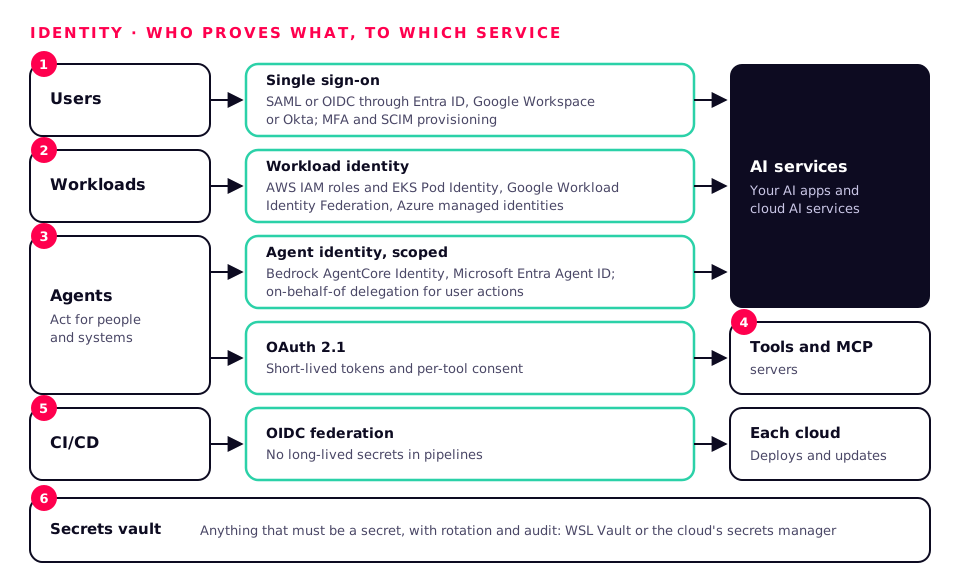
Gebruikers
Single sign-on via uw identiteitsprovider (Entra ID, Google Workspace, Okta) met SAML of OIDC, MFA en SCIM-provisioning.
Workloads
Cloud-native workload identity: AWS IAM-rollen en EKS Pod Identity, Google Workload Identity Federation, Azure managed identities.
Agents
Agentidentiteiten met hun eigen beperkte rechten, zoals Bedrock AgentCore Identity en Microsoft Entra Agent ID, met on-behalf-of-delegatie voor gebruikersacties.
Tools en MCP
OAuth 2.1 voor MCP-servers en tools van derden, kortlevende tokens en toestemming per tool.
CI/CD
OIDC-federatie van uw CI naar elke cloud, zodat pipelines geen langlevende secrets bevatten.
Secrets
Een vault voor alles wat een secret moet zijn, met rotatie en audit, zoals onze WSL Vault of de eigen secretsmanager van de cloud.
AI-workloads in de cloud optimaliseren
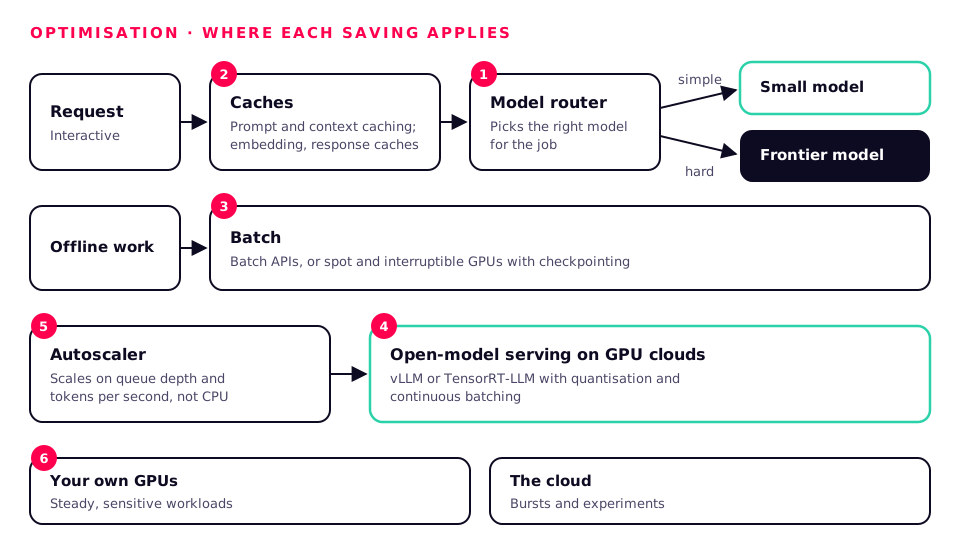
- Het juiste model voor de taak: stuur eenvoudige verzoeken naar kleine modellen en bewaar frontiermodellen voor moeilijke.
- Cache alles wat kan: prompt- en contextcaching, embeddingcaches en antwoordcaches voor herhaalde vragen.
- Bundel offline werk: batch-API's en spot- of onderbreekbare GPU's met checkpointing.
- Serveer open modellen efficiënt: vLLM of TensorRT-LLM met kwantisatie en continuous batching op GPU-clouds.
- Autoscale op het juiste signaal: wachtrijdiepte en tokens per seconde, niet CPU.
- Hybride by design: constante, gevoelige workloads op uw eigen GPU's, pieken en experimenten in de cloud.
Ondersteund door het Workstation-team
We zijn platformneutraal. We helpen u kiezen en ontwerpen, beveiligen, implementeren en beheren daarna AI op elk van deze clouds, naast uw eigen hardware.
- Architectuur en platformkeuze, inclusief kostenmodellering
- Landing zones met identiteit, netwerken en versleuteling
- Bedrock-, Vertex AI- en Azure AI Foundry-oplossingen en -agents
- Bouw van GPU-clusters op GPU-clouds
- CI/CD, evaluatie en ringgebaseerde releases
- Beveiligingsreviews van LLM- en agent-API's
- Hybride opstellingen met on-premises Workstation-hardware
Logo's zijn handelsmerken van hun respectieve eigenaars, worden alleen gebruikt om elk platform te identificeren en komen van Wikimedia Commons. Diagrammen door het Workstation-team.