Infrastructuur van ondernemingsniveau voor AI-training en -inferentie op schaal
Moderne AI-werklasten vragen om infrastructuur die daarvoor is gebouwd en kan meegroeien van één GPU-werkstation naar honderden verbonden knooppunten. Workstation AI levert de hulpmiddelen, architecturen en expertise om GPU-clusters te ontwerpen, uit te rollen en te beheren met Kubernetes als orkestratie, zodat uw teams zich richten op modelontwikkeling in plaats van op de complexiteit van de infrastructuur.
Overzicht van de GPU-clusterarchitectuur
Een goed ontworpen GPU-cluster combineert krachtige rekennodes met snelle interconnects, gedeelde opslag en intelligente orkestratie. Inzicht in de architectuur is de basis voor een betrouwbare AI-infrastructuur.
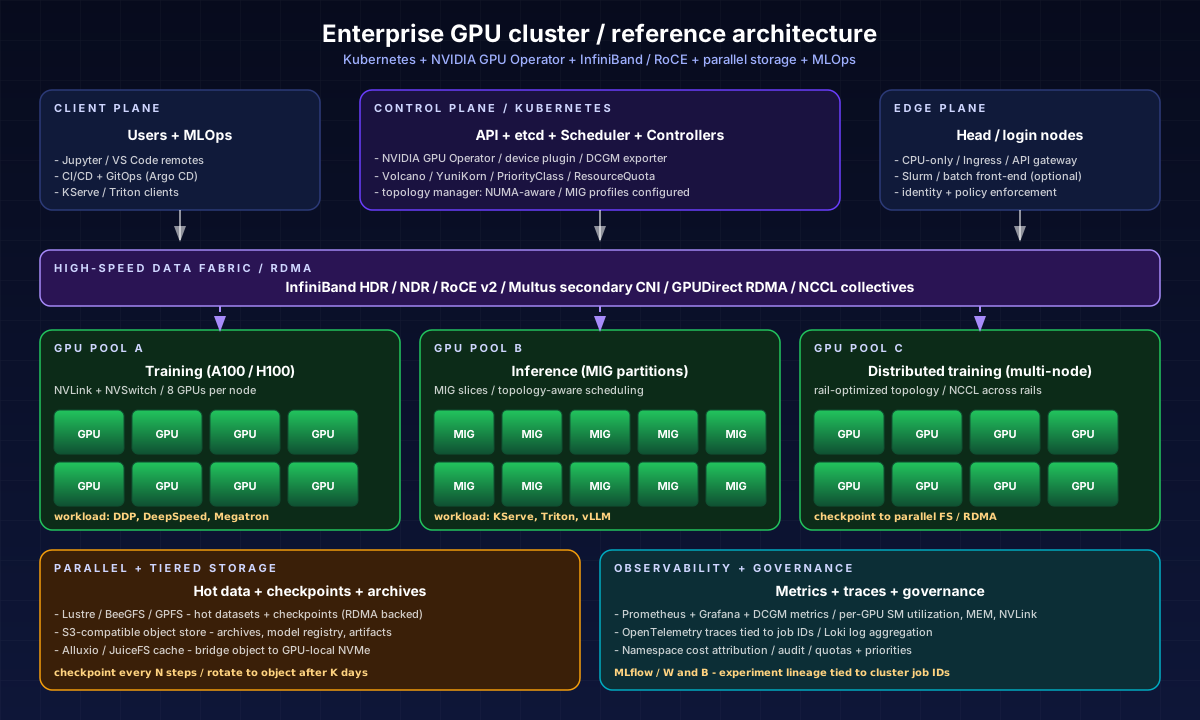
- Elke rekennode bevat doorgaans 4 tot 8 GPU's (NVIDIA A100, H100 of L40S), verbonden via NVLink of NVSwitch voor communicatie binnen de node met een bandbreedte tot 900 GB/s.
- Een speciaal managementplane verzorgt jobscheduling, resourcetoewijzing, health monitoring en toegangsbeheer, zodat het dataplane vrij blijft voor trainingsverkeer.
- Head nodes fungeren als toegangspoort waarlangs gebruikers jobs indienen, Jupyter-omgevingen openen en met MLOps-tooling werken, zonder GPU-resources te verbruiken.
- Snelle netwerkfabrics zoals InfiniBand HDR (200 Gbps) of RoCE v2 verbinden nodes voor gedistribueerde training en minimaliseren de latentie bij gradiëntsynchronisatie.
- Gedeelde parallelle bestandssystemen (Lustre, GPFS of BeeGFS) leveren de doorvoer die nodig is voor grootschalige dataset-I/O, zonder opslagknelpunten te veroorzaken.
Kubernetes voor AI-workloads
Kubernetes is de facto dé orchestrator voor AI-infrastructuur geworden, met declaratief resourcebeheer, automatische schaling en een rijk ecosysteem van GPU-bewuste componenten.
- ✓De NVIDIA GPU Operator automatiseert de uitrol van GPU-drivers, container toolkit, device plugins en monitoring-exporters op alle nodes, zodat handmatig driverbeheer verleden tijd is.
- ✓Kubernetes-device plugins maken GPU-resources zichtbaar voor de scheduler, wat fijnmazige toewijzing mogelijk maakt, zoals het aanvragen van specifieke GPU-modellen, MIG-slices (Multi-Instance GPU) of time-shared toegang.
- ✓Aangepaste schedulingbeleidsregels, zoals bin-packing, topologiebewuste plaatsing en gang scheduling, zorgen dat multi-GPU-jobs terechtkomen op nodes met de optimale interconnecttopologie.
- ✓Resourcequota per namespace en prioriteitsklassen laten teams een cluster delen, terwijl SLA's voor productie-inferentieworkloads voorrang krijgen boven experimentele trainingsruns.
- ✓Integratie met Volcano of Apache YuniKorn biedt batchscheduling die speciaal is gebouwd voor AI- en HPC-workloads, met fair-share-wachtrijen en job-preemption.
MLOps-pipelines op GPU-clusters
Een end-to-end MLOps-pipeline zet ruwe data om in uitgerolde modellen, met volledige reproduceerbaarheid, versiebeheer en observability in elke fase.
- ✓Pipelines voor data-ingestie en preprocessing draaien op CPU-nodes met Apache Spark of Dask en zetten opgeschoonde datasets in gedeelde opslag klaar voor de GPU-trainingsfasen.
- ✓Platforms voor experimenttracking zoals MLflow of Weights & Biases leggen hyperparameters, metrics en artefacten vast, zodat u honderden trainingsruns reproduceerbaar kunt vergelijken.
- ✓Frameworks voor gedistribueerde training (PyTorch DDP, DeepSpeed, Horovod) coördineren gradiëntupdates over meerdere GPU's en nodes, terwijl Kubernetes de plaatsing en levenscyclus van pods beheert.
- ✓Modelregistries versioneren getrainde modellen met metadata en herkomst en integreren met CI/CD-pipelines om validatie, A/B-tests en canary-deployments te automatiseren.
- ✓Inference serving met Triton Inference Server, vLLM of KServe levert voorspellingen met lage latentie, met dynamische batching, modelensembles en automatische GPU-schaling op basis van de aanvraagbelasting.
Netwerken voor gedistribueerde AI
Netwerkprestaties zijn vaak de bottleneck bij gedistribueerde training. De juiste fabric en configuratie kiezen is cruciaal voor efficiënt schalen.
- ✓InfiniBand HDR/NDR biedt met RDMA de laagste latentie en de hoogste bandbreedte (200-400 Gbps per poort), ideaal voor grootschalige training over 64+ nodes.
- ✓RoCE v2 (RDMA over Converged Ethernet) is een kosteneffectief alternatief dat over standaard Ethernet-switches draait en toch RDMA ondersteunt voor minder CPU-overhead.
- ✓Netwerktopologie doet ertoe: fat-tree- en rail-geoptimaliseerde ontwerpen minimaliseren oversubscription, terwijl het SHARP-protocol van NVIDIA collectieve bewerkingen naar de netwerkswitches zelf verplaatst.
- ✓In Kubernetes-omgevingen kunnen pods met Multus CNI zowel op het primaire clusternetwerk als op een secundair snel RDMA-netwerk voor trainingsverkeer worden aangesloten.
- ✓Netwerkisolatie met SR-IOV virtual functions geeft elke trainingspod directe hardwaretoegang tot de netwerkadapter, waarbij de kernelstack wordt omzeild voor prestaties op wire speed.
Opslagoplossingen voor AI-workloads
AI-workloads hebben uiteenlopende opslagbehoeften: parallelle reads met hoge doorvoer voor trainingsdata, toegang met lage latentie voor checkpoints en duurzame objectopslag voor datasets en artefacten.
- ✓NFS blijft een praktische keuze voor kleinere clusters en gedeelde homedirectory's, al maakt de beperkte doorvoer het ongeschikt als primaire opslag voor trainingsdata zodra het om meer dan een paar nodes gaat.
- ✓Ceph biedt een uniform opslagplatform met block- (RBD), file- (CephFS) en objectinterfaces (RGW) en schaalt horizontaal tot petabytes, met ingebouwde replicatie en erasure coding.
- ✓Longhorn, een lichte Kubernetes-native opslagoplossing, levert gerepliceerde blockopslag, ideaal voor modelcheckpoints en persistent volumes in kleinere GPU-clusters.
- ✓Krachtige cachinglagen met Alluxio of JuiceFS kunnen de kloof overbruggen tussen trage objectopslag (S3-compatibel) en de doorvoereisen van GPU-dataloaders.
- ✓Een gelaagde opslagstrategie is essentieel: snelle NVMe-SSD's op rekennodes voor scratch en checkpoints, parallelle bestandssystemen voor actieve datasets en koude objectopslag voor archivering.
GPU-gebruik monitoren
Inzicht in de gezondheid en het gebruik van GPU's is essentieel om het rendement op de infrastructuurinvestering te maximaliseren en prestatieknelpunten te signaleren voordat ze trainingsruns raken.
- ✓DCGM (Data Center GPU Manager) Exporter verzamelt meer dan 50 GPU-metrics, waaronder SM-gebruik, geheugenbandbreedte, temperatuur, stroomverbruik en ECC-foutentellingen, om door Prometheus te laten scrapen.
- ✓Grafana-dashboards bieden realtime en historisch inzicht in het gebruik per GPU, per node en per job, zodat teams ongebruikte resources opsporen en toewijzingen goed dimensioneren.
- ✓Alerts op GPU-geheugengebruik, thermal throttling en Xid-fouten maken proactief onderhoud mogelijk, zodat hardwarestoringen geen meerdaagse trainingsruns onderbreken.
- ✓Integratie met Kubernetes-metrics (kube-state-metrics) koppelt GPU-gebruik aan beslissingen over podscheduling, zodat beheerders bin-packing en de omvang van nodepools kunnen optimaliseren.
- ✓Kostentoerekening per namespace of team op basis van GPU-uren maakt chargebackmodellen mogelijk die efficiënt resourcegebruik stimuleren en uitbreiding van de infrastructuur onderbouwen.
Opschalen van workstation naar datacenter
Kies de juiste schaal voor uw AI-ambities. Elk niveau bouwt voort op het vorige en Workstation AI biedt migratiepaden daartussen.
| Niveau | GPU's | Toepassing | Netwerken | Opslag | Orkestratie |
|---|---|---|---|---|---|
| Eén workstation | 1-2 GPU's | Prototyping, fine-tuning van kleine modellen, inferentieontwikkeling | PCIe / NVLink | Lokale NVMe-SSD | Docker / Docker Compose |
| Klein cluster | 8-32 GPU's (2-4 nodes) | Modeltraining tot 7B parameters, inference serving voor meerdere modellen | 25-100 GbE / RoCE v2 | NFS / Longhorn | K3s / MicroK8s |
| Middelgroot cluster | 32-128 GPU's (4-16 nodes) | Training van modellen met 7B-70B parameters, productie-inferentie op schaal | InfiniBand HDR 200G | Ceph / BeeGFS | Kubernetes + GPU Operator |
| Grootschalig cluster | 128-1000+ GPU's (16-128 nodes) | Training van foundation models, multi-tenant AI-platform | InfiniBand NDR 400G | Lustre / GPFS + objectopslag | Kubernetes + Volcano + Slurm |
End-to-end MLOps-pipeline
From data ingestion to model serving, a well-architected MLOps pipeline on Kubernetes automates every stage of the machine learning lifecycle.
Data Ingestion
Preprocessing
Distributed Training
Experiment Tracking
Model Registry
Inference Serving
Plan uw GPU-cluster
Of u nu opschaalt vanaf één werkstation of een AI-trainingsplatform met meerdere knooppunten ontwerpt, ons team helpt u de juiste infrastructuur te bepalen voor uw werklasten en uw budget.