De Workstation-blog
AI Agents
Berichten met de tag AI Agents.
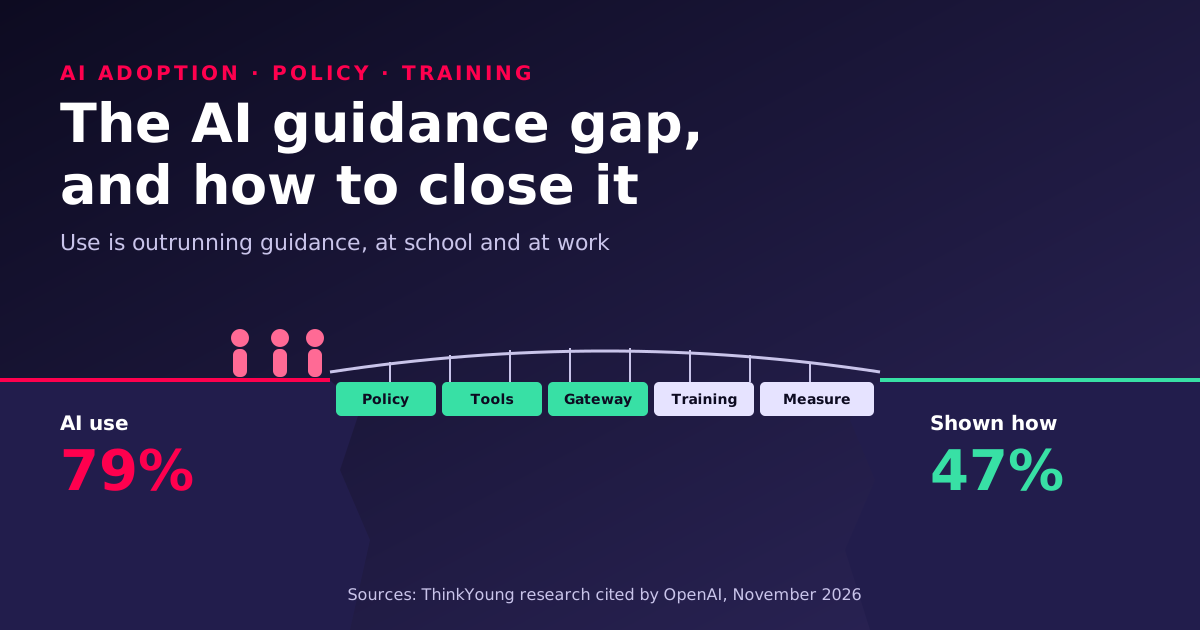
The AI Guidance Gap: Use Outpaces Training at School and at Work
79% of students use AI for homework but only 47% were shown how, according to ThinkYoung research cited by OpenAI. Workplaces show the same gap. A 90-day playbook for business leaders: policy by data class, approved tools, a gateway, role-based training and usage metrics.
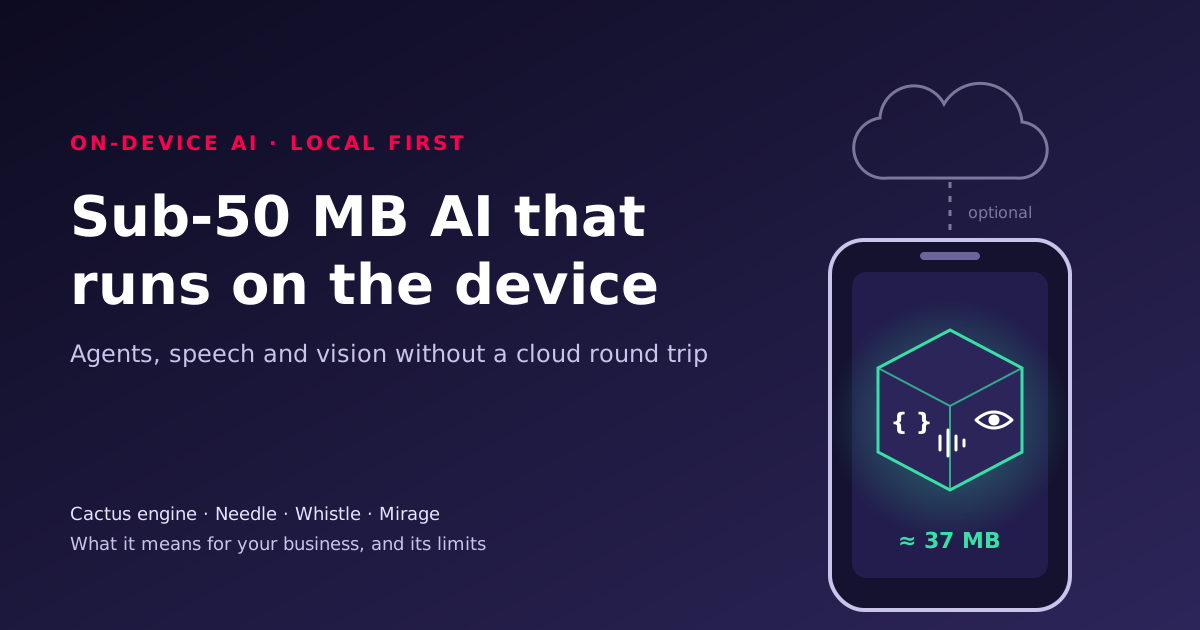
Sub-50 MB On-Device AI: What Cactus's Engine Means for Business
Cactus Compute's open-source engine (not NVIDIA's, as first reported) runs tool calling, speech and vision models under 50 MB each on phones and laptops. What it is, what we measured, its limits, and which AI tasks belong on the device.
Vanuit de zaal op GTC Berlin: Huang zegt dat AI nu productief is
Engineers van Workstation waren in STATION-Berlin voor de keynote van 21 oktober 2026. Huangs wending ging van fabrieken naar agents die tokens verbruiken.
 Balinder WaliaLezen
OpenShell, aangekondigd op GTC Berlin: beleid buiten de agent
De beveiligingsfilm van Huang verwierp ‘doe dat alstublieft niet’ als controlemaatregel. OpenShell dwingt beleid af op syscalls, bestanden en netwerk, met Sentry op BlueField-4.
Balinder WaliaLezen 
De Berlijnse slide die documenten scheidt van databases
Nemotron Parse, Embed, cuVS en Rerank op de ene rij. Auto-Ontology, cuDF en Kumo op de andere. Huangs voorbeeld van een vertraagde leverancier gebruikt beide.
Balinder WaliaLezen 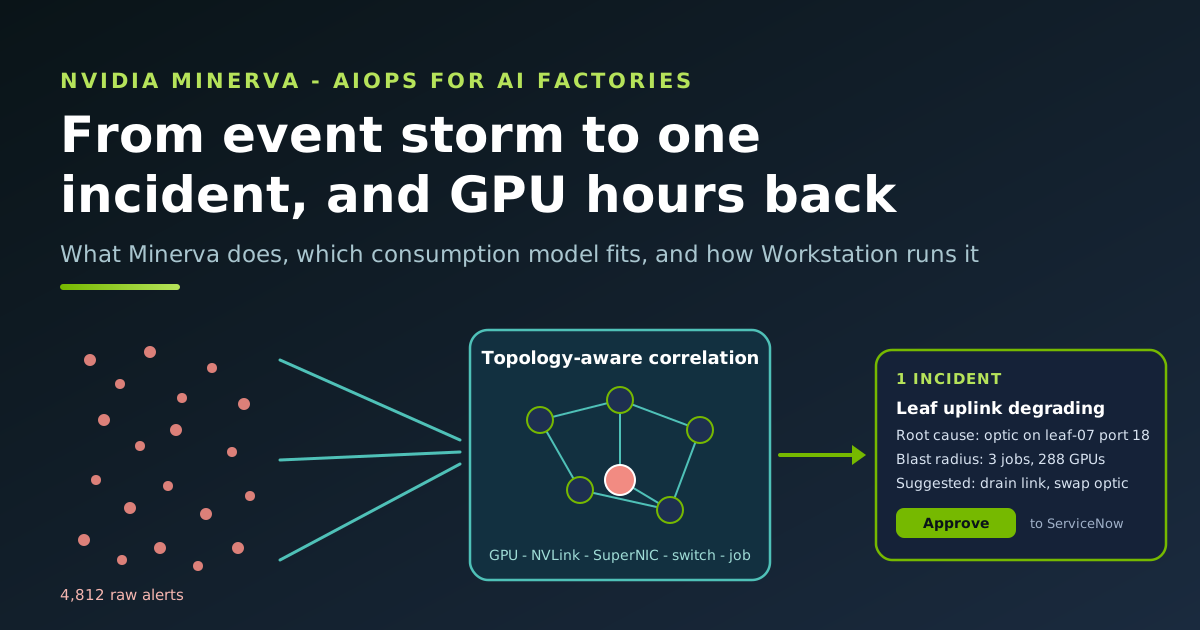
NVIDIA Minerva voor AI-fabrieken: van alertstormen naar teruggewonnen GPU-uren
Eén optiek die achteruitgaat kan duizenden alerts veroorzaken en duizend GPU's stilleggen. Wat NVIDIA Minerva doet, wat het waard is in GPU-uren, goodput, MTBI, MTTR en tokens, welk van de drie afnamemodellen past, uitgewerkte voorbeelden voor een Vera Rubin NVL72-neocloud, een Blackwell-cluster van een universiteit en een organisatie met Grafana en ServiceNow, en hoe het zich verhoudt tot UFM.
Balinder WaliaLezen 
AI-agents bouwen met NebulaDB: semantisch zoeken, RAG en een Visa AI Agent
Hoe we semantisch zoeken, RAG en een Thaise Visa AI Agent op NebulaDB bouwden, met echte queries, queryplannen en retrievalscores gemeten op onze productieserver met 8,3 miljoen documenten, en de controles die privédata en verzonnen getallen uit de antwoorden houden.
Balinder WaliaLezen 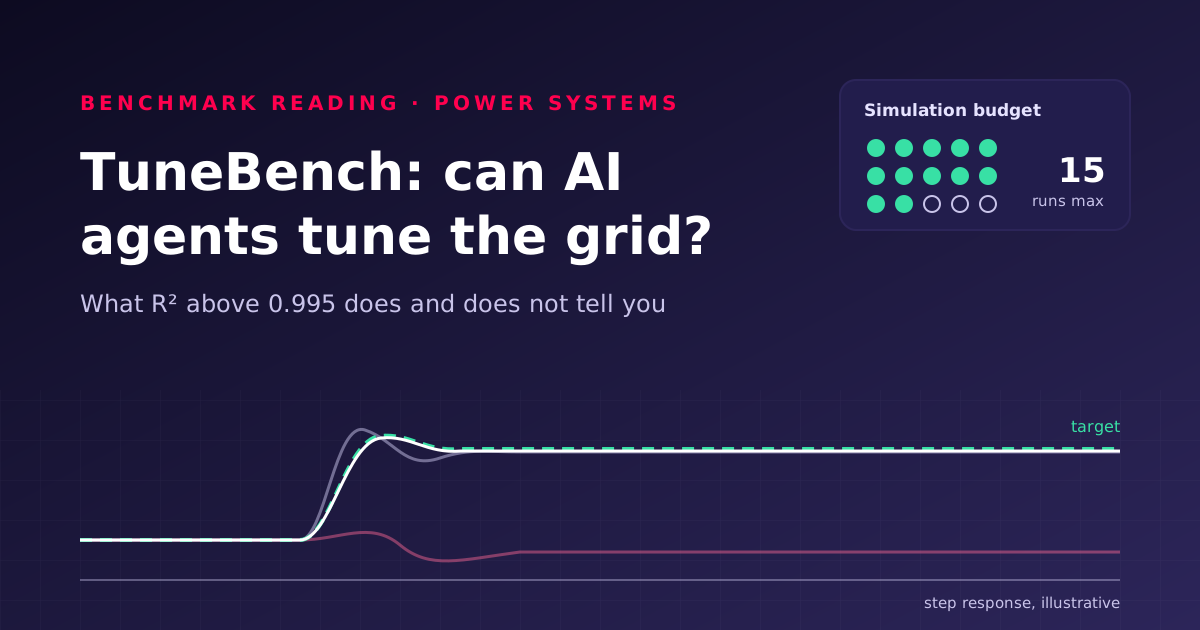
TuneBench: How Well Can AI Agents Calibrate Power System Models?
TuneBench tests LLM agents on calibrating generator and battery models within 15 simulations. Only Opus 5.5 and GPT-6 hit median R² above 0.995 in every test. What that figure means, its limits, and how to build the same kind of benchmark.
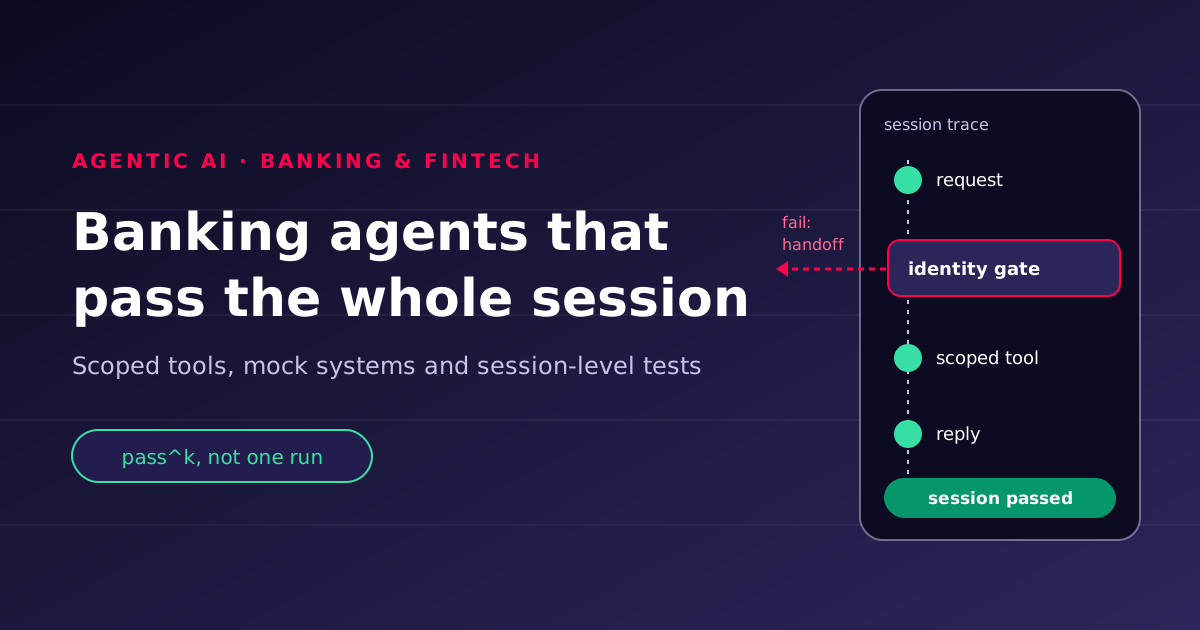
Agentic AI in banking: efficiency you can defend to a risk committee
Banking AI agents rarely fail on one bad reply; they fail across a session. How to scope tools, test whole conversations against mock systems and measure reliability with pass^k, so the time saved survives audit and production.
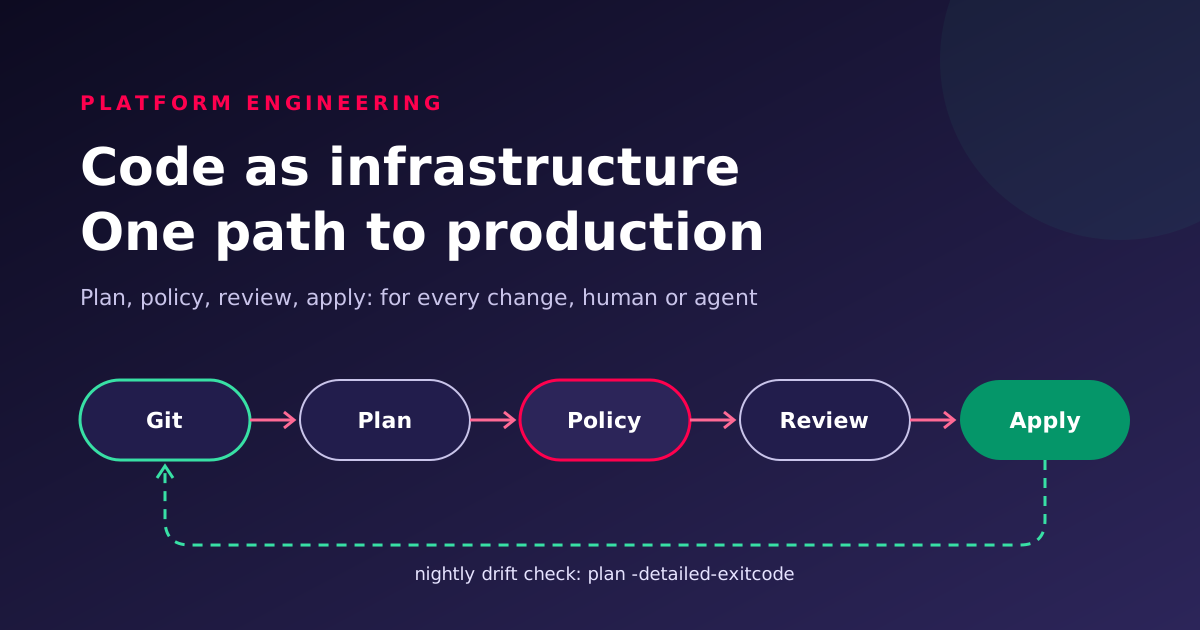
Code as infrastructure: one reviewed path for every production change
Infrastructure as code made servers into files. Code as infrastructure goes further: desired state, policy, pipelines and AI agent access all live in Git, are checked by policy, applied by automation and watched for drift. A practical playbook.