 Workstation team
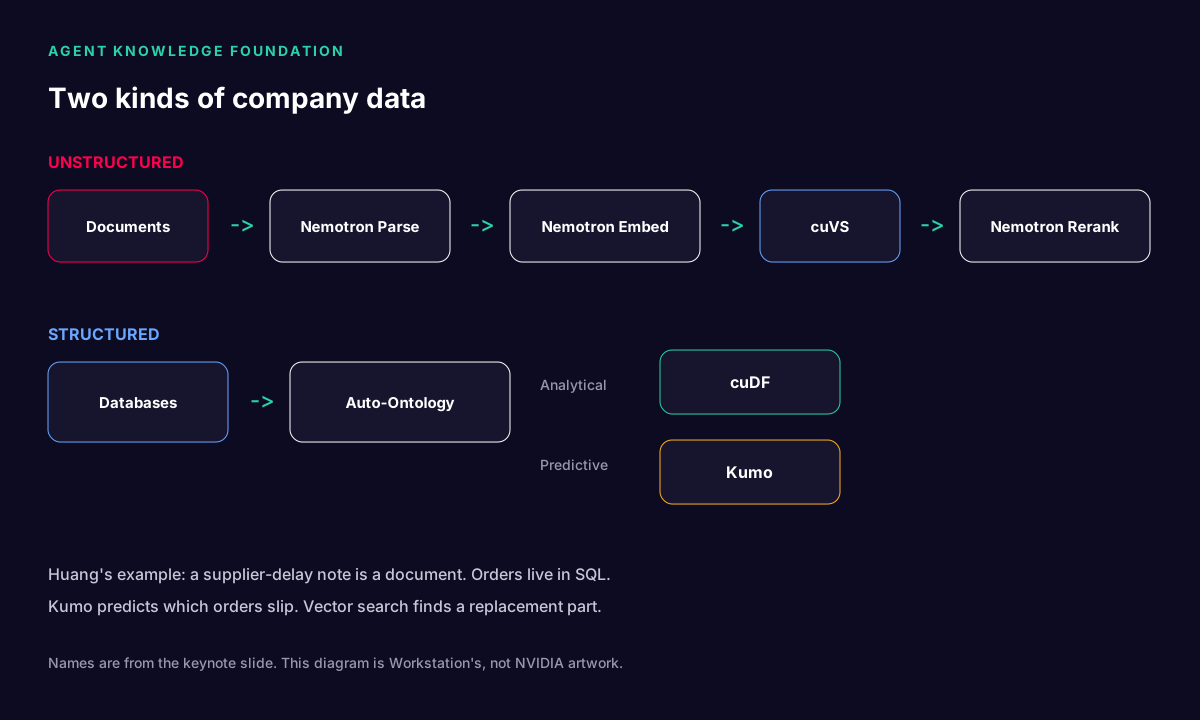
De Agent Knowledge Foundation-slide op GTC Berlin splitst bedrijfsdata in tweeën. Documenten gaan door Nemotron Parse, Nemotron Embed, cuVS en Nemotron Rerank. Databases gaan door Auto-Ontology en daarna door cuDF voor analyse en Kumo voor voorspelling. Dit bericht legt elk blok uit, noemt de opensourceframeworks die hetzelfde werk doen en loopt het patroon door in twee vakgebieden waar beide soorten data elke dag samenkomen: de zorg en wetenschappelijk onderzoek. Inclusief de chatassistenten en robots die daar al aan het werk zijn.
Wat Huang zei
Een vertraging bij een leverancier komt binnen als document. De orders die van die leverancier afhangen, staan in SQL. Huang zei dat u Kumo gebruikt om te voorspellen welke orders uitlopen, en vector search om in de engineeringbestanden een vervangend onderdeel te vinden. Het keynotetranscript verhaspelt Kumo tot "QMO" en "CUMA". Op de slide staat Kumo. Wij volgen de slide.
Hij zei ook dat Nemotron wordt geleverd met gewichten, data en de scripts om het opnieuw te bouwen, en dat het niet automatisch een frontier-taalmodel is totdat iemand het post-traint. Een van de partnervoorbeelden die hij vanaf het podium gaf, kwam uit de zorg: Palantir dat samenwerkt met Tampa General Hospital. De volledige lijst, zoals hij die noemde, staat in het lange artikel. Het zijn zijn voorbeelden, niet de onze, en wij hebben de samenwerkingen niet geverifieerd.
De documentbaan, blok voor blok
Dit is retrieval-augmented generation (RAG), getekend als vier afzonderlijke taken in plaats van één blok. Die splitsing is belangrijk, omdat elke stap op zijn eigen manier faalt en een eigen test nodig heeft.
- Parse. Zet een pdf, scan of slidedeck om in schone tekst, tabellen en figuurbijschriften, met behoud van pagina en positie. Klinische brieven en labrapporten staan vol tabellen, kopteksten en handschrift. Een parser die een resultatentabel platslaat tot een reeks getallen, vergiftigt alles wat daarna komt. Nemotron Parse is het model van NVIDIA hiervoor. Open alternatieven zijn onder meer Docling (van IBM), Unstructured en Marker. Clouddiensten zijn onder meer Azure Document Intelligence en AWS Textract.
- Embed. Zet elke passage en elke vraag om in een vector, zodat "kortademigheid" en "dyspneu" dicht bij elkaar terechtkomen. Nemotron Embed doet dit. Veelgebruikte open modellen zijn onder meer BGE-M3, E5 en Nomic Embed. Test elke embedder op uw eigen vocabulaire voordat u erop vertrouwt, want algemene modellen gaan vaak slecht om met geneesmiddelnamen en gensymbolen.
- Search. Vind snel de dichtstbijzijnde vectoren in miljoenen passages. cuVS is de GPU-bibliotheek van NVIDIA hiervoor, en de CAGRA-graafindex ervan wordt ook binnen Milvus en FAISS gebruikt. Voor kleinere collecties is pgvector in een bestaande PostgreSQL-database vaak genoeg. Qdrant en Weaviate zijn andere gangbare keuzes. Combineer vector search met gewone zoektermen (BM25), want identificatoren zoals NHS-nummers, batchcodes en gennamen vereisen een exacte match.
- Rerank. Zoeken levert vijftig plausibele passages op. Een reranker leest elke passage tegen de vraag en zet de vijf die de vraag echt beantwoorden bovenaan. Nemotron Rerank doet dit. Open alternatieven zijn onder meer de BGE-rerankers en late-interactionmodellen in ColBERT-stijl. In onze ervaring is reranking de goedkoopste nauwkeurigheidswinst in de hele pipeline.
De uitvoer van deze baan moet altijd bestaan uit passages met hun bronnen, niet uit een kant-en-klaar antwoord. De agent schrijft het antwoord. De bronvermelding laat een mens het controleren.
De tabelbaan, blok voor blok
- Auto-Ontology. Voordat een model over een database kan redeneren, moet iets vastleggen wat de kolommen betekenen en hoe de tabellen aan elkaar koppelen. "obs_cd 8867-4" zegt een agent niets totdat hij weet dat het een LOINC-code voor hartslag is. Huangs slide plaatst hier een automatische stap. In de zorg bestaat het grootste deel van de ontologie al: SNOMED CT voor klinische termen (gebruikt in de hele Britse eerstelijnszorg van de NHS), LOINC voor observaties, dm+d voor Britse geneesmiddelen, ICD-10 en OPCS-4 voor diagnoses en verrichtingen. In de wetenschap zijn er ChEBI voor chemische stoffen, de Gene Ontology en UniProt. Map naar deze standaarden in plaats van uw eigen te verzinnen. De semantische laag van dbt en knowledge-graphtools zoals Neo4j zijn gangbare manieren om de mapping vast te leggen.
- Analytisch: cuDF. cuDF is de GPU-dataframebibliotheek uit het RAPIDS-project van NVIDIA. De modus
cudf.pandasversnelt bestaande pandas-code zonder die te herschrijven, en Polars kan cuDF als GPU-engine gebruiken. Dit is de kant van "hoeveel, hoe veel, vergeleken met vorige maand". Voor de meeste vragen is SQL eerlijk gezegd de eerste tool. Een taalmodel dat SQL schrijft tegen een goed beschreven schema (text-to-SQL) en de query laat zien, is veel makkelijker te auditen dan een model dat getallen raadt. - Voorspellend: Kumo. Kumo bouwt voorspellingen rechtstreeks over veel gekoppelde tabellen met graph neural networks, in plaats van dat een data scientist met de hand features bouwt. Het bedrijf heeft een voorgetraind relationeel foundation model gepubliceerd, KumoRFM. De academische benchmark voor dit soort werk is RelBench van Stanford. Het conventionele alternatief blijft gradient-boosted trees zoals XGBoost over handmatig ontworpen features. Gebruik wat u kunt valideren, en valideer op data uit een periode die het model nooit heeft gezien.
De frameworks die het samenbinden
De twee banen zijn bibliotheken. Iets moet beslissen wanneer ze worden aangeroepen, state bijhouden en limieten afdwingen. Dat is de agent-harness, en de keynote in Berlijn zette die eerst in een sandbox (zie ons bericht over OpenShell).
| Taak | NVIDIA-stack | Gangbare open-source- of leveranciersopties |
|---|---|---|
| Documenten parsen | Nemotron Parse, NeMo Retriever-extractie | Docling, Unstructured, Marker, LlamaParse |
| Embedden en reranken | Nemotron Embed, Nemotron Rerank | BGE-M3, E5, Nomic Embed, BGE reranker, ColBERT |
| Vector search | cuVS (CAGRA) | Milvus, FAISS, pgvector, Qdrant, Weaviate |
| Tabellen analyseren | cuDF, RAPIDS | SQL, DuckDB, Polars, pandas, dbt |
| Voorspellen over tabellen | Kumo (partner) | XGBoost, LightGBM, PyTorch Geometric |
| Knowledge graph | Auto-Ontology-stap | Neo4j, Microsoft GraphRAG, RDF- en OWL-tools |
| Agent-orkestratie | NeMo Agent Toolkit, AI-Q blueprint | LangGraph, LlamaIndex, Haystack, CrewAI, Microsoft Agent Framework (AutoGen), DSPy |
| Toolkoppelingen | NIM-microservices | Model Context Protocol (MCP), Agent2Agent (A2A) |
| Taalmodel | Nemotron | Llama, Qwen, Mistral, Gemma en MedGemma, of een gehost frontier-model |
| Robots | Isaac Sim, Isaac Lab, Cosmos, GR00T, Holoscan | ROS 2, MoveIt, Hugging Face LeRobot, openpi |
Geen van deze is verplicht. Een klein team kan een degelijke eerste versie bouwen met Docling, pgvector, een reranker, PostgreSQL en LangGraph of LlamaIndex op één GPU-workstation. De NVIDIA-onderdelen verdienen hun plek wanneer het corpus tientallen miljoenen passages bereikt of de tabellen miljarden rijen.
Zorg: waarom beide banen nodig zijn
Een ziekenhuis is het duidelijkste voorbeeld van Huangs splitsing. Het meeste van wat zorgverleners over een patiënt weten, staat op schrift: verwijsbrieven, polikliniekaantekeningen, ontslagbrieven, radiologie- en pathologieverslagen. Wat wordt geteld, zoals uitslagen, voorschriften, bedbezetting en afspraken, staat in het elektronisch patiëntendossier en het bijbehorende datawarehouse. Klinische vragen hebben bijna altijd beide nodig.
Huangs leveranciersvoorbeeld, vertaald
Vervang de late leverancier door een geneesmiddelentekort.
- Een tekortmelding of een Serious Shortage Protocol komt binnen als pdf of e-mail. De documentbaan parset die en haalt het product, de sterktes en de data eruit.
- De tabelbaan mapt het product naar dm+d-codes en bevraagt de voorschrijfgegevens: welke patiënten gebruiken het, hoeveel voorraad elke apotheek heeft en wanneer de volgende levering voor elke patiënt gepland staat.
- Een voorspellend model rangschikt welke patiënten het eerst zonder komen te zitten, op basis van de afleverhistorie en polikliniekroosters.
- Vector search in het lokale formularium, de richtlijnen en de tekortmelding vindt de goedgekeurde alternatieven, met bronvermelding.
- De agent stelt een werklijst op voor een apotheker: patiënt, risico, voorgesteld alternatief en bron. De apotheker beslist. De agent wijzigt niets in het dossier.
Dat is dezelfde vorm als het leveranciersvoorbeeld: één document, meerdere tabellen, één voorspelling, één zoekopdracht, één menselijke beslissing.
Chatassistenten die al in gebruik zijn
Dit zijn echte producten en onderzoekssystemen. Wij noemen ze om de patronen te laten zien, niet om een ervan aan te bevelen.
- Ambient klinische documentatie. Microsoft Dragon Copilot (voortgekomen uit Nuance DAX) en Abridge luisteren mee met een consult en stellen een concept van het verslag op dat de zorgverlener kan bewerken. NHS England publiceerde in 2025 richtlijnen over ambient voice technology, over klinische veiligheid, gegevensbescherming en de noodzaak dat de zorgverlener elk verslag controleert. Dit is de documentbaan in omgekeerde richting: de AI schrijft het document.
- Triage en zelfverwijzing voor patiënten. Limbic Access wordt door NHS Talking Therapies-diensten gebruikt voor zelfverwijzing en is in het Verenigd Koninkrijk gecertificeerd als medisch hulpmiddel klasse IIa. Het is een goed voorbeeld van een chatbot met een bewust smalle en gereguleerde scope.
- Niet-diagnostische zorgagents. Hippocratic AI bouwt spraakagents voor taken zoals herinneringen vóór een operatie en controlegesprekken na ontslag, en kondigde in 2024 een samenwerking met NVIDIA aan. De ontwerpkeuze die telt is "niet-diagnostisch": de agent volgt op en escaleert, maar stelt geen diagnose.
- Evidence search voor zorgverleners. OpenEvidence beantwoordt klinische vragen op basis van de gepubliceerde literatuur, met bronvermelding. Het is de documentbaan, toegepast op vaktijdschriften in plaats van op de eigen bestanden van een ziekenhuis.
- Medische modellen. MedGemma van Google is een open-weight modelfamilie voor medische tekst en beelden, en het onderzoekssysteem AMIE bestudeert diagnostische dialoog. Open weights betekent dat een ziekenhuis ze op eigen hardware kan draaien en op eigen data kan testen.
- Een waarschuwing uit het verleden. De symptoomchecker van Babylon Health werd breed gepromoot en het bedrijf ging in 2023 ten onder. Ambitieuze diagnostische claims zonder bijpassend bewijs zijn de snelste manier om het vertrouwen van zorgverleners te verliezen.
Robots in ziekenhuizen
- Chirurgische systemen zoals de da Vinci van Intuitive en de Versius van CMR Surgical (gebouwd in Cambridge) worden op afstand bediend: de chirurg heeft de controle. Onderzoek beweegt richting autonomie voor delen van een ingreep. In 2025 meldde een team van Johns Hopkins dat een robot de stappen van een galblaasverwijdering autonoom uitvoerde op ex-vivoweefsel, niet bij patiënten.
- Logistieke robots zoals Moxi van Diligent Robotics halen en brengen benodigdheden en monsters, zodat verpleegkundigen minder hoeven te lopen. Afleverrobots zijn al gangbaar in NHS-ziekenhuisapotheken.
- De NVIDIA-stack voor dit werk bestaat uit Holoscan voor realtime sensor- en videoverwerking in medische apparatuur, Isaac for Healthcare voor het simuleren en trainen van medische robots, en MONAI, het opensourceframework voor medische beeldvorming dat NVIDIA samen met King's College London is gestart.
Bij robots raakt het kennisfundament de fysieke wereld. Een bezorgrobot heeft de tabelbaan (welke afdeling, welk bed, welk monster spoed heeft) veel meer nodig dan een chatbot.
De Britse regels die het ontwerp bepalen
- Klinische veiligheid: DCB0129 voor de fabrikant en DCB0160 voor de organisatie die het systeem inzet, elk met een benoemde clinical safety officer en een hazard log.
- Wetgeving voor medische hulpmiddelen: software die een diagnose stelt of een behandeling aanbeveelt, kan volgens de regels van de MHRA een medisch hulpmiddel zijn. De AI Airlock van de MHRA is een regulatory sandbox voor precies deze producten. In de EU behandelt de AI Act AI in medische hulpmiddelen als hoog risico.
- Gegevensbescherming: gezondheidsgegevens zijn bijzondere persoonsgegevens onder de UK GDPR. Reken op een gegevensbeschermingseffectbeoordeling (DPIA) en houd identificeerbare gegevens buiten prompts, logs en modeltraining, tenzij daar een rechtsgrond voor is.
- Inkoop: NHS-organisaties beoordelen leveranciers met de Digital Technology Assessment Criteria (DTAC) en de Data Security and Protection Toolkit (DSPT).
- Toegang voor onderzoek: beveiligde data-omgevingen van de NHS en trusted research environments zoals OpenSAFELY brengen de code naar de data in plaats van andersom. Een agent die binnen die grens draait, op hardware die de organisatie zelf beheert, past veel beter bij dit model dan een agent die dossiers naar een externe API stuurt.
Wetenschappelijk onderzoek: dezelfde twee banen
Laboratoria kennen dezelfde splitsing. Kennis zit in artikelen, preprints, elektronische labjournaals, protocollen en handleidingen van instrumenten. Metingen zitten in het laboratory information management system (LIMS), platereaders, sequencers en simulatie-uitvoer, vaak in volumes die alleen GPU's comfortabel aankunnen.
Het leveranciersvoorbeeld, in een lab
- Een reagensleverancier roept een lot terug. De melding wordt geparset.
- Het LIMS toont elk monster en elke plaat waarvoor dat lot is gebruikt.
- Een analytische query (cuDF of SQL) controleert of resultaten van dat lot ten opzichte van de controles zijn verschoven. Een voorspellend model markeert welke vervolgexperimenten het meest waarschijnlijk zijn getroffen.
- Vector search in de SOP's en labjournaals van het lab vindt het gevalideerde alternatieve reagens en een eventuele eerdere bridgingstudie.
- De agent stelt een plan voor herhaling op. Een wetenschapper keurt het goed en een pipetteerrobot voert het protocol uit.
Frameworks en modellen die wetenschappers al gebruiken
- Modellen voor biologie en chemie. NVIDIA BioNeMo bundelt modellen en trainingsrecepten voor eiwitten, DNA en kleine moleculen, waaronder Evo 2, gebouwd met het Arc Institute. AlphaFold 3 van Google DeepMind en Isomorphic Labs voorspelt structuren en interacties, en de makers ervan deelden de Nobelprijs voor Scheikunde 2024. Open alternatieven zijn onder meer OpenFold en Boltz, en ESM3 van EvolutionaryScale genereert eiwitten.
- Data op schaal. RAPIDS en cuDF versnellen tabulair werk. rapids-singlecell van het scverse-project draait single-cellanalyse op GPU's. NVIDIA Parabricks versnelt pipelines voor genoomsequencing. Earth-2 en PhysicsNeMo bestrijken klimaat- en natuurkundige simulatie.
- Onderzoeksagents. Coscientist (Carnegie Mellon, 2023) en ChemCrow lieten zien hoe taalmodelagents met tools scheikunde plannen en uitvoeren. PaperQA2 van FutureHouse beantwoordt vragen uit de literatuur met bronvermelding. De AI co-scientist van Google (2025) genereert en rangschikt hypotheses. De AI-Q blueprint van NVIDIA is een referentieontwerp voor onderzoeksassistenten, gebouwd op de onderdelen van de slide.
Labrobots en zelfrijdende labs
- Pipetteerrobots. Opentrons-robots worden geprogrammeerd met een open Python-protocol-API, wat ze tot een vanzelfsprekende tool maakt voor een agent: de agent schrijft of kiest een protocol, een wetenschapper beoordeelt het, de robot voert het uit.
- Mobiele robotchemici. De mobiele robotchemicus van de University of Liverpool, in 2020 beschreven in Nature, voerde over meerdere dagen honderden experimenten uit en koos zelf wat hij daarna zou proberen. A-Lab van Berkeley Lab automatiseerde materiaalsynthese. Sommige van de ontdekkingsclaims werden betwist, een nuttige herinnering dat autonome labs onafhankelijke controle nodig hebben.
- Cloudlabs zoals Emerald Cloud Lab laten wetenschappers experimenten op afstand in code uitvoeren.
- Robot learning. Isaac Sim en Isaac Lab simuleren robots voordat ze een echte labtafel aanraken. Cosmos genereert synthetische trainingsvideo. GR00T is het foundation model van NVIDIA voor humanoïde robots. In open source blijven ROS 2 en MoveIt het standaard leidingwerk, en LeRobot van Hugging Face en openpi van Physical Intelligence publiceren robotpolicy's die iedereen kan finetunen.
Vijf ontwerpregels die in beide vakgebieden gelden
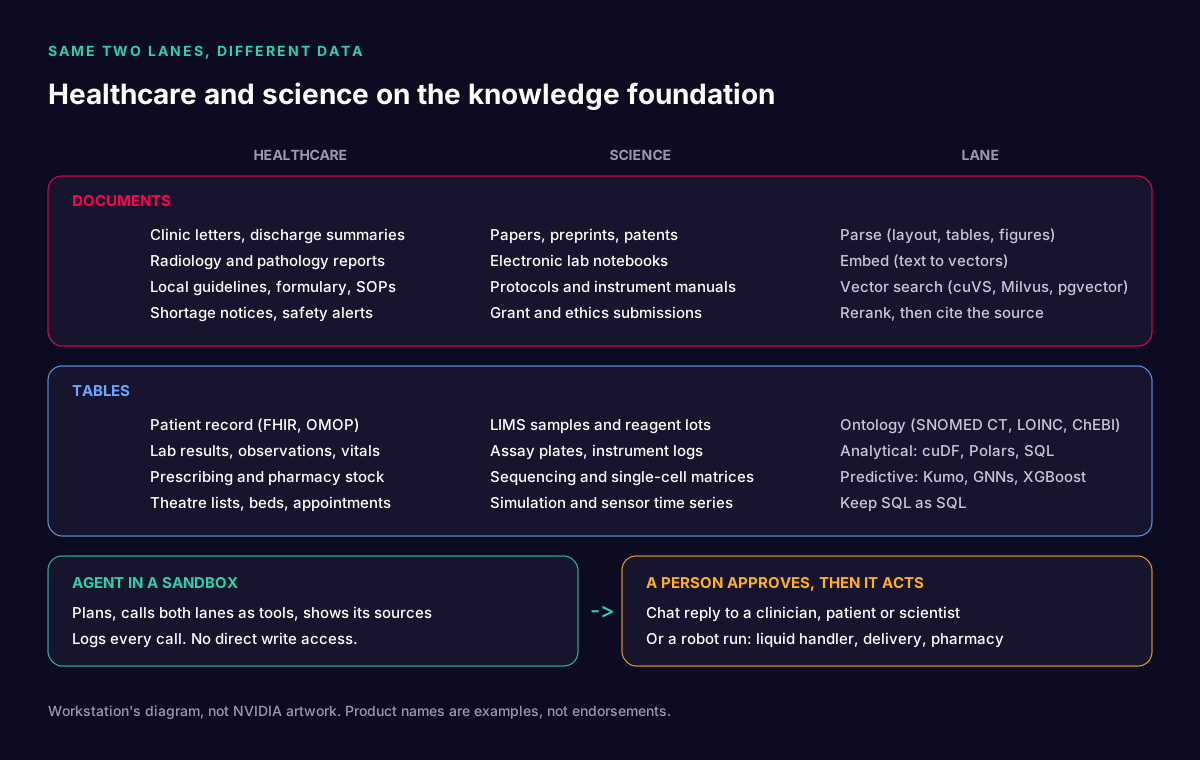
- Routeer op datavorm. Documenten gaan naar retrieval. Tabellen gaan naar SQL, analyse of voorspelling. Vraag de agent te vermelden welke baan hij heeft gebruikt.
- Citeer of zwijg. Elk antwoord over een patiënt of een experiment moet linken naar de passage of query erachter. Als retrieval niets vindt, is het juiste antwoord "Ik kon dit niet vinden".
- Standaard alleen-lezen. De agent doet een voorstel. Een zorgverlener, apotheker of wetenschapper keurt goed. Schrijfacties in het dossier, bestellingen en robotruns gaan via een aparte, gelogde stap.
- Evalueer op uw eigen data. Bouw een testset van echte vragen met bekende antwoorden uit uw eigen documenten en tabellen, en draai die telkens wanneer een model, parser of prompt verandert. Publieke leaderboards kennen uw formularium of uw assay niet.
- Houd gevoelige data waar die is. Open-weight modellen zoals Nemotron, Llama, Qwen en MedGemma kunnen draaien op hardware binnen het ziekenhuis of het lab. Dat maakt gesprekken over gegevensbescherming, audit en onderzoeksgovernance veel korter.
Hoe een verstandig eerste project eruitziet
Kies één vraag die mensen nu al met de hand beantwoorden, die zowel een document als een tabel nodig heeft, en waarbij een fout antwoord door een mens wordt opgevangen voordat het ertoe doet. Werklijsten bij tekorten, conceptontslagbrieven die door de zorgverlener worden beoordeeld, literatuurtriage voor een onderzoeksgroep of impactrapporten bij reagensterugroepingen zijn allemaal goede kandidaten. Draai het op één GPU-workstation binnen uw netwerk, meet een maand lang de nauwkeurigheid tegen uw testset, en praat pas daarna over schaal.
Wilt u hulp bij het dimensioneren van die machine, of bij het draaien van de open modellen op hardware die u zelf bezit, neem dan contact met ons op. Onze gids voor private-AI-workstations laat de dimensioneringsmethode zien voor een ander gereguleerd beroep.
Product- en onderzoeksnamen worden genoemd als voorbeelden van echte systemen en zijn handelsmerken van hun eigenaren. Niets hierin is klinisch, regelgevend of juridisch advies. Controleer uw eigen verplichtingen op het gebied van klinische veiligheid, medische hulpmiddelen en gegevensbescherming voordat u AI inzet bij patiënten of patiëntgegevens.