NVIDIA Minerva voor AI-fabrieken: van alertstormen naar teruggewonnen GPU-uren
Wat Minerva doet, welk afnamemodel bij wie past, drie uitgewerkte voorbeelden en hoe Workstation het levert, integreert en ondersteunt
 Balinder Walia9 november 202611 min read
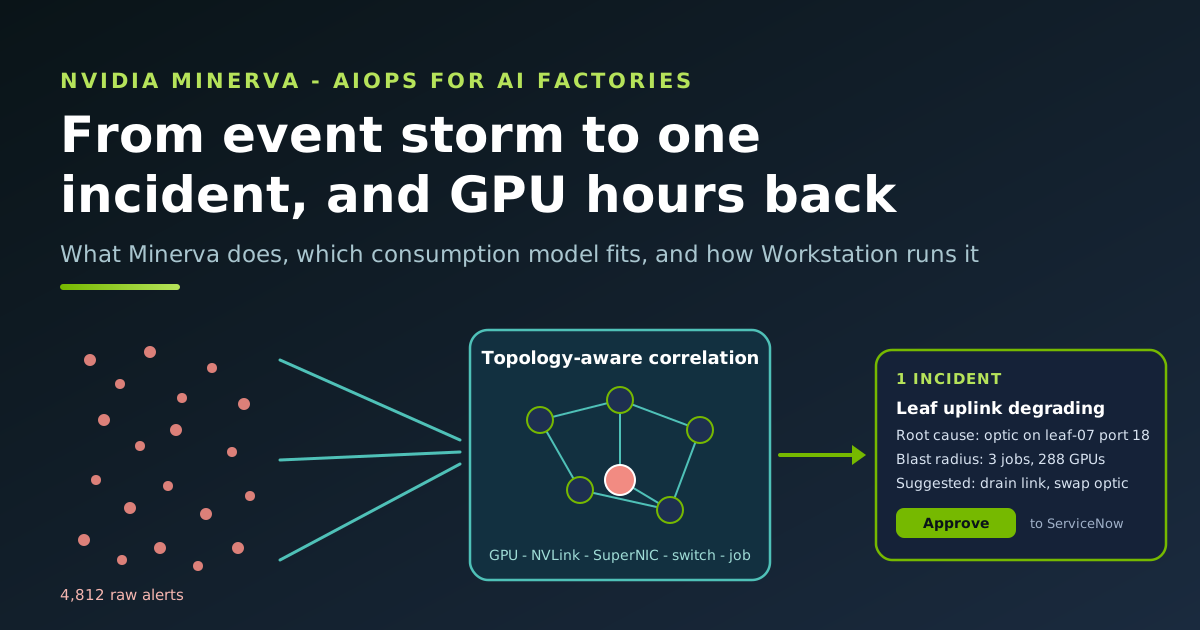
Een AI-fabriek verdient zichzelf terug in GPU-uren en tokens, en verliest ze stilletjes: een achterblijvende node, een optiek die achteruitgaat, een storm van alerts die niemand op tijd kan lezen. Dit bericht is bedoeld voor CTO's, operators van AI-fabrieken en neoclouds en hoofden research computing. Het legt in gewone taal uit wat NVIDIA Minerva is, wat het het bedrijf waard is, welk van de drie afnamemodellen bij welke organisatie past, hoe het zich verhoudt tot NVIDIA UFM en hoe Workstation het levert, inricht, integreert en ondersteunt. Engineers die de architectuur, de integratieconfiguratie en het uitrolrunbook willen zien, lezen het technische artikel.
Interactieve versie: open zeventien voorbeelddashboards voor een Minerva-implementatie, van het rendement van de AI-fabriek tot de gezondheid van de collectors, met de signalen en alertrichtlijnen achter elk dashboard.

Wat NVIDIA Minerva is, in gewone taal
NVIDIA kondigde Minerva aan in oktober 2026 en beschrijft het op de officiële NVIDIA Minerva-pagina als het belangrijkste observabilityproduct voor zijn AI-fabrieken, waaronder systemen op basis van de Vera Rubin- en Blackwell-platforms. Zonder jargon doet het vijf dingen:
- Verzamelt alles één keer. GPU-gezondheid, de NVLink-switches die GPU's binnen een rack verbinden, Spectrum-X Ethernet-switches en SuperNICs die racks met elkaar verbinden, DPU's, NCCL (de bibliotheek die GPU's gebruiken om resultaten uit te wisselen), jobschedulers zoals Slurm en NVIDIA Run:ai, opslag en de AI-workloads zelf. Het neemt dit op via open standaarden: OpenTelemetry, gNMI-streaming vanuit switches, syslog, DCGM voor GPU's, Slurm-data en gewone JSON.
- Houdt een live kaart bij. Een knowledge graph legt vast welke GPU in welke node zit, welke poort met welke switch is verbonden en welke job waar draait, en werkt bij terwijl jobs komen en gaan.
- Leert wat normaal is en ziet afwijkingen. Machine learning bouwt per signaal een baseline op en markeert de drift die meestal aan een storing voorafgaat.
- Verklaart in plaats van alleen te alarmeren. Als er iets misgaat, loopt het de kaart af om de gedeelde oorzaak achter de symptomen te vinden, bepaalt het welke jobs en GPU's zijn getroffen en stuurt het één incident naar Slack, Microsoft Teams, PagerDuty of ServiceNow.
- Praat terug. Met een assistent genaamd Sherlock kunnen operators in gewone taal vragen stellen over live telemetrie, en via een MCP-server (Model Context Protocol) kunnen uw eigen AI-agents Minerva bevragen. Waar u het toestaat, kunnen aanbevolen oplossingen automatisch worden uitgevoerd, bijvoorbeeld via Ansible.
Het kan in uw eigen datacenter draaien of als dienst die door NVIDIA wordt gehost, en volgens NVIDIA schaalt het naar honderdduizenden GPU's. De Minerva Collector maakt ook deel uit van NVIDIA DSX OS, waardoor hetzelfde overzicht zich kan uitstrekken van de GPU tot de stroomvoorziening en koeling van het gebouw.
Waarom het voor het bedrijf belangrijk is
Een AI-fabriek is een zeer dure machine waarvan de output bestaat uit tokens en getrainde modellen. Alles wat haar stillegt, vertraagt of moeilijk te repareren maakt, is direct terug te zien in de kosten per token. NVIDIA beschrijft de waarde van Minerva in dezelfde termen waarover operators al rapporteren, en dat doen wij ook:
- Teruggewonnen GPU-uren. Storingen die jobs stilletjes vertragen, zoals één achterblijvende node die duizenden GPU's bij elke synchronisatiestap ophoudt, worden binnen minuten gevonden in plaats van dagen.
- Hogere goodput. Goodput is het aandeel GPU-tijd dat nuttig werk oplevert, nadat herstarts, herhalingen en wachttijd eraf zijn gehaald. Dat is het getal dat telt, niet de ruwe bezettingsgraad.
- Minder onderbrekingen (hogere MTBI). De gemiddelde tijd tussen onderbrekingen gaat omhoog wanneer falende onderdelen vroeg worden opgemerkt en in een gepland venster worden vervangen in plaats van midden in een run.
- Sneller herstel (lagere MTTR). De gemiddelde hersteltijd daalt wanneer het eerste bericht al de waarschijnlijke oorzaak en het impactgebied noemt.
- Rustigere on-call. Eén incident in plaats van duizenden alerts betekent dat mensen op het juiste reageren, en in hun baan blijven.
- Meer tokens. Bij inferentie is elk uur met verminderde doorvoer verloren output en, voor een provider, verloren omzet.
- Datasoevereiniteit. Een on-premises-implementatie houdt telemetrie, topologie en jobmetadata binnen uw eigen omgeving, wat belangrijk is voor de Britse publieke sector, onderzoek en gereguleerde klanten.
Drie afnamemodellen, en voor wie elk model geschikt is
NVIDIA biedt Minerva op drie manieren aan, van doe-het-zelf tot volledig turnkey. Wij helpen klanten kiezen door te vragen wat ze al draaien en hoeveel van de analyse ze zelf willen beheren.
| Model | Wat u krijgt | Geschikt voor | Denk aan |
|---|---|---|---|
| DIY Observability | Minerva als collector voor telemetrie van de AI-fabriek, die uw eigen observabilitytools zoals Grafana voedt. | Teams met een volwassen Prometheus- en Grafana-praktijk die op NVIDIA afgestemde dataverzameling willen zonder van tools te wisselen. | U bouwt en onderhoudt de dashboards, alerts en correlatie zelf. |
| AIOps with DIY Observability | De collector plus de machine learning, anomaliedetectie en correlatie van Minerva, met de inzichten teruggevoerd naar uw bestaande tools en agents. | Organisaties met een gevestigde Grafana-, ServiceNow- of PagerDuty-stack die minder en betere alerts willen zonder een nieuwe console. | Integratie en alertroutering vragen een zorgvuldig ontwerp, zodat incidenten één keer in de juiste wachtrij terechtkomen. |
| Turnkey | Het complete platform: verzameling, inzichten, de Sherlock-assistent en de eigen dashboards en gebruikersinterface van Minerva. | AI-fabrieken en neoclouds die vanaf dag één één operationeel overzicht willen dat is afgestemd op de referentiearchitecturen van NVIDIA. | Bepaal vroeg hoe het samengaat met monitoring die u al draait voor systemen zonder GPU's. |
Licenties, edities en ondersteuningsvoorwaarden komen van NVIDIA en kunnen veranderen, dus wij bevestigen ze bij elke offerte. De keuze is ook niet definitief: veel klanten beginnen met de collector en voegen AIOps toe zodra ze de data vertrouwen.
Drie voorbeelden
De getallen hieronder zijn illustratief en uitgewerkt om de vorm van de businesscase te laten zien. Uw kosten per GPU-uur, jobmix en storingsfrequentie zullen afwijken.
1. Een neocloud met ongeveer duizend Vera Rubin-GPU's
Veertien Vera Rubin NVL72-racks, 1.008 GPU's, op een Spectrum-X Ethernet-fabric, verhuurd aan klanten voor grote trainingsruns en inferentie. Bij illustratieve integrale kosten van £6 per GPU-uur vertegenwoordigt de omgeving ongeveer 8,8 miljoen GPU-uren per jaar, dus elke 1% verloren goodput kost zo'n £530.000.
- Ons gebruikelijke advies: Turnkey Minerva on-premises, met de collector uitgerold als onderdeel van DSX OS zodat stroom en koeling van de faciliteit op dezelfde tijdlijn staan als de GPU's, en incidenten die naar de ServiceNow van de provider worden gerouteerd.
- Waar het geld zit: stel dat de trainingsjob van een tenant acht racks beslaat (576 GPU's) en dat elke onderbreking ongeveer 50 minuten aan werk en herstarttijd kost, grofweg 480 GPU-uren. Van één onderbreking per twee dagen naar één per drie dagen gaan voorkomt ongeveer 60 onderbrekingen per jaar, zo'n 29.000 GPU-uren of £175.000 voor alleen die ene jobklasse.
- Voorbeeld: een node met een langzaam achteruitgaande NVLink-verbinding wordt een achterblijver. Zonder correlatie draait de job gewoon 15% langzamer en klaagt de klant dagen later. Met correlatie wordt de achterblijver binnen minuten benoemd, wordt de job bij het volgende checkpoint van de node gehaald en wordt de tray in een gepland venster onderhouden.
2. Een universiteit met een Blackwell-cluster van 256 GPU's
Tweeëndertig HGX B300-servers, 256 GPU's, via Slurm gedeeld door onderzoeksgroepen en beheerd door een klein centraal team dat voor al het andere al Grafana gebruikt. Bij £2,50 per GPU-uur is 1% van het clusterjaar ongeveer 22.400 GPU-uren, oftewel £56.000.
- Ons gebruikelijke advies: begin met DIY Observability en stuur de door Minerva verzamelde data naar de bestaande Grafana van het team, met GPU- en jobdata getagd per Slurm-job zodat elke afdeling het eigen gebruik ziet. Stap over op AIOps with DIY Observability zodra het team geautomatiseerde root-cause-analyse van mislukte jobs wil.
- Bedrijfsresultaat: onderbouwde antwoorden op de twee vragen die elke research-computingdienst krijgt: "waarom is mijn job mislukt?" en "wie heeft de GPU's gebruikt?". Dat ondersteunt doorbelasting, financieringsaanvragen en eerlijke scheduling.
- Een opmerking over de fabric: als het GPU-netwerk van het cluster InfiniBand is in plaats van Spectrum-X Ethernet, blijft NVIDIA UFM de tool die die fabric beheert en bewaakt; zie ons bericht over UFM. Wij bevestigen met NVIDIA hoe Minerva- en UFM-data worden gecombineerd voor de release die u koopt.
3. Een organisatie die Grafana, ServiceNow en PagerDuty al in gebruik heeft
Een financiële dienstverlener draait 128 Blackwell-GPU's (zestien HGX B300-servers) voor interne inferentie, ongeveer 2 miljard tokens per dag. Het operationele team leeft al in Grafana, ServiceNow en PagerDuty en wil geen extra console.
- Ons gebruikelijke advies: AIOps with DIY Observability, on-premises voor datasoevereiniteit. De gecorreleerde incidenten van Minerva maken ServiceNow-tickets en PagerDuty-pages aan; de inzichten verschijnen in de bestaande Grafana; Sherlock en de MCP-server worden alleen-lezen ingeschakeld voor het platformteam.
- Bedrijfsresultaat (illustratief): zo'n 3.000 ruwe alerts per week worden een paar dozijn incidenten, en het aantal pages naar de on-call-engineer daalt van meer dan honderd per week naar ongeveer vijftien. De gemiddelde hersteltijd daalt van ongeveer drie uur naar minder dan een uur, omdat het ticket de oorzaak al noemt.
- Impact op tokens: een vertraging van vier uur die de doorvoer met 30% verlaagt, kost ongeveer 100 miljoen tokens aan output. Wie die in 30 minuten opmerkt, behoudt het grootste deel daarvan.
Minerva en UFM: wat doet wat?
Ons eerdere bericht over NVIDIA UFM behandelde Unified Fabric Manager, de software van NVIDIA voor het beheren en monitoren van InfiniBand-fabrics: subnetbeheer, partities, fabrictelemetrie en storingsvoorspelling. Minerva heeft een andere reikwijdte:
- UFM is een fabricmanager. Het configureert en beheert een InfiniBand-netwerk en rapporteert over de gezondheid ervan.
- Minerva is een AIOps-platform voor de hele AI-fabriek. Volgens de beschrijving van NVIDIA bestrijkt het compute, NVLink-scale-up, Spectrum-X Ethernet-scale-out en -scale-across, schedulers, opslag en workloads, en is het zijn taak om over al die lagen te correleren en te diagnosticeren, niet om het netwerk te beheren.
Een InfiniBand-cluster heeft dus nog steeds een subnetmanager zoals UFM nodig, en een Spectrum-X AI-fabriek krijgt haar netwerkobservability van Minerva. Waar een locatie beide heeft, ontwerpen wij één labelschema en één incidentstroom, zodat de twee mensen niet dubbel oproepen.
Wat Workstation doet
Wij zijn een Britse reseller en integrator van NVIDIA AI-infrastructuur. Voor Minerva betekent dat:
- Levering. De Minerva-licentie in het juiste model, samen met de systemen die het bewaakt: Vera Rubin NVL72-racks, DGX- en HGX-systemen, Spectrum-X Ethernet, SuperNICs en BlueField-DPU's.
- Inrichting en integratie. Wij rollen de collectors uit en, waar nodig, een OpenTelemetry-laag voor uw bestaande bronnen; koppelen Minerva aan Slack of Teams, PagerDuty en ServiceNow; voeden Grafana; configureren Slurm- of Run:ai-metadata; en draaien een baselineperiode voordat er iemand wordt opgeroepen.
- Automatisering veilig maken. Toegang tot Sherlock en MCP begint alleen-lezen. Herstelacties lopen via goedgekeurde Ansible-playbooks met changerecords, en wij bewijzen de werking met storingsoefeningen vóór de overdracht.
- Ondersteuning en beheer. Onze engineers ondersteunen Minerva en de omliggende softwarediensten dagelijks, stemmen de ruisonderdrukking af, houden de collectorlaag gezond en hoog beschikbaar en rapporteren maandelijks over GPU-uren, goodput, MTBI en MTTR. Wij werken samen met uw team en met NVIDIA-support.
Vragen om te stellen voordat u koopt
- Wat kost een uur van uw AI-fabriek, en hoeveel goodput denkt u vandaag te verliezen?
- In welke tools leeft uw operationele team al, en moet Minerva die voeden of vervangen?
- Moeten telemetrie en jobmetadata on-premises blijven, en wie mag ze inzien?
- Hoeveel automatisering staat uw changeproces toe, en wie keurt die goed?
- Is uw GPU-fabric Spectrum-X Ethernet, InfiniBand of beide?
NVIDIA-partner: engineering, software en mensen
Workstation is een NVIDIA-partner. Naast het leveren van de hardware bieden wij de engineering, software en medewerkers om AI-datacenters te plannen, te bouwen en te beheren: locatie- en stroomonderzoeken, rack- en fabricontwerp, installatie van Spectrum-X, NVLink en InfiniBand, inrichting van Minerva, UFM, DCGM en OpenTelemetry, onboarding van Kubernetes, Run:ai en Slurm, en engineers die bij u blijven tijdens de overdracht en het beheer. Voor de eigen beschrijving van het product door NVIDIA, zie de officiële NVIDIA Minerva-pagina en het Minerva-datasheet (beide openen in een nieuw tabblad).
Volgende stappen
Open de interactieve dashboardgalerij om de zeventien overzichten te zien die wij rond een Minerva-implementatie inrichten. Bekijk daarna NVIDIA Minerva in onze shop, of vraag onze AI Sales Engineer om de implementatie, het afnamemodel en de omliggende systemen te dimensioneren. Wij beginnen graag met een observabilityreview van een AI-cluster dat u al draait.
De cijfers in dit bericht zijn illustratieve voorbeelden, geen metingen bij een specifieke klant.
Erkenning van rechten: NVIDIA, het NVIDIA-logo, Minerva, Sherlock (als naam van de assistent van NVIDIA), DSX, DSX OS, DGX, HGX, Vera Rubin, Blackwell, Spectrum, Spectrum-X, NVLink, ConnectX, SuperNIC, BlueField, DCGM, NCCL, Run:ai en Unified Fabric Manager (UFM) zijn handelsmerken en/of geregistreerde handelsmerken van NVIDIA Corporation in de Verenigde Staten en andere landen. NVIDIA-producten en -technologieën kunnen worden beschermd door octrooien en andere intellectuele-eigendomsrechten van NVIDIA Corporation, en al die rechten worden erkend en voorbehouden aan hun eigenaren. Productinformatie is in onze eigen woorden samengevat uit openbaar materiaal van NVIDIA; de website en documentatie van NVIDIA zijn de gezaghebbende bron. Andere bedrijfs- en productnamen, waaronder Grafana, Prometheus, Slack, Microsoft Teams, PagerDuty, ServiceNow, Ansible, OpenTelemetry, Slurm en Kubernetes, kunnen handelsmerken zijn van hun respectieve eigenaren. De eigen dashboards, configuraties en teksten van Workstation zijn © Workstation.