NVIDIA UFM voor AI-clusters: waarom zicht op uw InfiniBand-fabric bepaalt wat uw GPU's waard zijn
De drie UFM-niveaus, drie praktijkvoorbeelden van clusters en hoe Workstation de monitoring levert, inricht en beheert
 Balinder Walia9 november 202612 min read
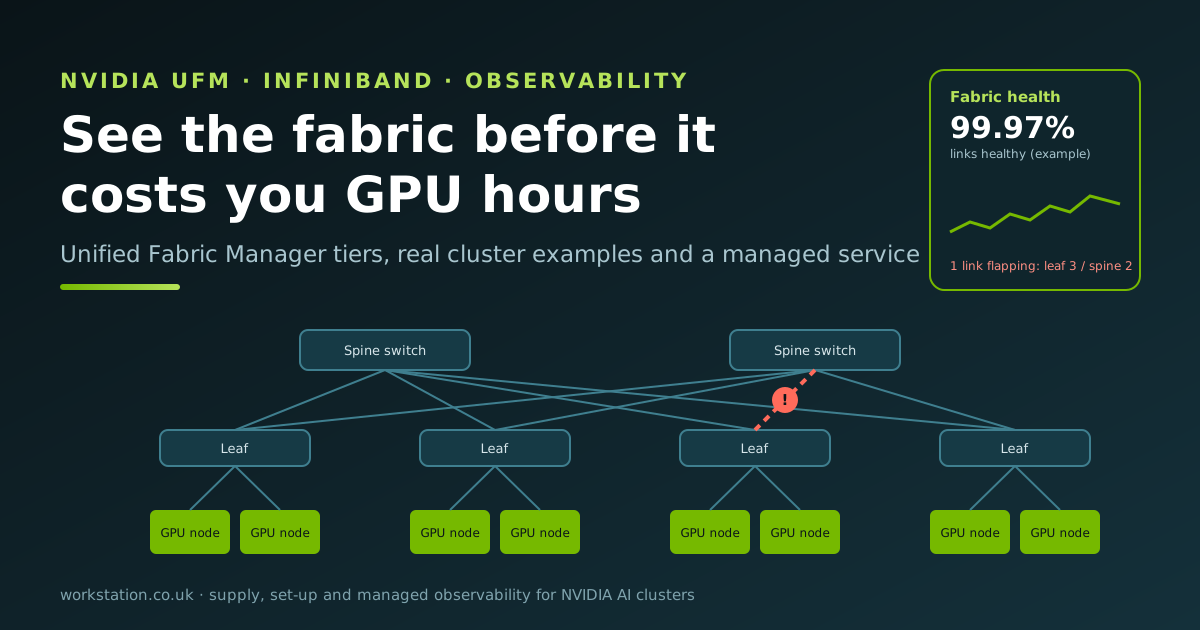
De GPU's krijgen de aandacht en het budget. Het netwerk dat ze verbindt, bepaalt hoeveel van dat budget in nuttig werk verandert. Dit bericht is bedoeld voor IT-directeuren, CTO's en hoofden research computing die een NVIDIA InfiniBand-cluster draaien of aanschaffen. Het legt in gewone taal uit wat NVIDIA Unified Fabric Manager (UFM) doet, welk van de drie niveaus bij welk cluster past, wat beter zicht op de fabric waard is in GPU-uren en hoe Workstation de monitoring voor u levert, inricht en beheert. Engineers die de plugins, de OpenTelemetry-configuratie en de alertregels willen zien, lezen het technische artikel.
Interactieve versie: open zeventien voorbeelddashboards, van fabricgezondheid tot kosten per GPU-uur, met de query's en alertdrempels achter elk dashboard.

Waarom de fabric bepaalt wat uw GPU's waard zijn
Een groot model trainen, of het over meerdere servers serveren, is voor GPU's teamwerk. Om de paar milliseconden stoppen ze en wisselen ze via het netwerk resultaten met elkaar uit. De job kan maar zo snel gaan als de traagste uitwisseling. Als één link van de honderden met fouten draait, pakketten opnieuw verstuurt of stilletjes terugvalt naar een lagere snelheid, wacht elke GPU in die job erop.
Dat maakt AI-netwerken anders dan kantoornetwerken. Op een normaal netwerk ergert een trage link een paar gebruikers. Op een AI-fabric verandert een trage link een job van 256 GPU's in een wachtrij van 256 GPU's. En het symptoom lijkt niet op een netwerkprobleem. Het lijkt op "de training is deze week trager" of "de GPU's halen maar 60%". Teams besteden dan dagen aan het tunen van software die nooit de oorzaak was.
De rekensom is eenvoudig genoeg om aan een financieel directeur voor te leggen. Neem een cluster van 256 GPU's en geef elk GPU-uur integrale kosten van £2,50 (afschrijving van hardware, stroom, koeling, ruimte en support; uw bedrag zal afwijken). Dat cluster vertegenwoordigt ongeveer 2,24 miljoen GPU-uren per jaar:
- 1% bezetting verliezen door fabricproblemen kost ongeveer £56.000 per jaar.
- Eén flapperende link die een trainingsrun van 256 GPU's drie uur stillegt voordat iemand het merkt, kost ongeveer 770 GPU-uren, oftewel £1.900, plus de herstart vanaf het laatste checkpoint.
- Een falende transceiver die in een gepland venster wordt vervangen in plaats van midden in een run, bespaart nogmaals hetzelfde, plus de oproep in het weekend.
Dit zijn illustratieve cijfers, maar de vorm is altijd hetzelfde: de kosten van het goed bewaken van de fabric zijn klein vergeleken met de GPU-tijd die het beschermt.
Wat NVIDIA UFM is, in gewone taal
InfiniBand is het netwerk dat de meeste grote AI- en HPC-clusters tussen GPU-servers gebruiken, omdat het snel en voorspelbaar is en veel werk van de servers overneemt. Elke InfiniBand-fabric heeft een subnetmanager nodig, de software die elke switch en adapter ontdekt, routes berekent en de fabric draaiende houdt. NVIDIA Unified Fabric Manager is de software van NVIDIA om die fabric op datacenterschaal te beheren en te bewaken.
Zie het als drie taken in één productfamilie: NVIDIA beschrijft het volledige platform op de officiële UFM-pagina.
- Zien. Tellers verzamelen van elke switchpoort, adapter en kabel: verkeer, fouten, herhalingen, temperaturen, linksnelheden. Ze live tonen en de historie bewaren.
- Beheren. De topologie ontdekken, de subnetmanager beheren, de fabric opdelen in geïsoleerde partities voor verschillende teams of klanten, firmware en configuratie consistent toepassen, en events en alarmen genereren.
- Voorspellen. Leren hoe normaal eruitziet voor uw fabric en de kabel markeren die slechter wordt, of het verkeerspatroon dat niet past, voordat het misgaat.
UFM heeft ook een open software development kit met plugins die de data naar de tools sturen die uw operationele team al gebruikt: Prometheus en Grafana, Elasticsearch via Fluentd, Zabbix, syslog en de jobscheduler Slurm. Dat is belangrijk, want niemand wil nog een scherm om in de gaten te houden. Wij behandelen de plugins uitgebreid in het technische artikel.
De drie UFM-niveaus en wanneer elk past
NVIDIA levert UFM in drie hoofdniveaus. De namen beschrijven wat elk niveau toevoegt:
| Niveau | Wat het toevoegt | Past het best wanneer | Let op |
|---|---|---|---|
| UFM Telemetry | Realtime verzameling van fabrictellers en kabeldata, gestreamd naar uw eigen monitoringtools. Alleen zichtbaarheid. | Kleinere clusters waar de subnetmanager al op een switch draait, of teams die alleen fabricdata in Grafana nodig hebben. | Geen partitiebeheer, geen centrale fabricbesturing en geen high-availabilitypaar. |
| UFM Enterprise | Alles uit Telemetry, plus volledig fabricbeheer: discovery, topologieweergaven, besturing van de subnetmanager, partities, events en alarmen, gezondheidsrapporten, een REST API, schedulerintegratie en een active/standby-HA-paar. | De meeste AI-clusters in productie, alles wat tussen teams of tenants wordt gedeeld, en elk cluster dat Slurm draait. | Vereist speciale managementservers (of de appliance van NVIDIA), en iemand die er eigenaar van is. |
| UFM Cyber-AI | Analyse bovenop de telemetriehistorie van Enterprise: leert het normale gedrag van elke fabric, voorspelt falende links en kabels en markeert afwijkingen in prestaties of gebruik. | Grote fabrics met duizenden kabels, waar het voorspellen van storingen zichzelf terugverdient, en providers die GPU-capaciteit verkopen en misbruik moeten opsporen. | De waarde groeit met de omvang en historie van de fabric; op een cluster met één switch is het meestal meer dan u nodig hebt. |
Exacte functies, licenties en applianceopties veranderen tussen UFM-releases, dus wij bevestigen de actuele samenstelling bij elke offerte met NVIDIA. De beslislogica is echter stabiel: Telemetry als u de fabric alleen hoeft te zien, Enterprise als u hem moet beheren, Cyber-AI als de fabric groot genoeg is dat het voorspellen van storingen echt geld bespaart.
Drie clusters, drie antwoorden
1. Een cluster van vier DGX B300- of HGX B300-nodes
Vier servers met elk acht GPU's, 32 GPU's in totaal, gebruikt door één AI-team voor finetuning en inferentie. Elke server heeft acht netwerkadapters van 800 Gb/s voor de GPU-fabric, dus er zijn 32 computepoorten, die op één InfiniBand-switch passen.
- Ons gebruikelijke advies: draai de subnetmanager op de switch en gebruik UFM Telemetry om fabrictellers in dezelfde Grafana te laden die de GPU-bezetting toont. Als het cluster later groeit of wordt gedeeld, begin dan met UFM Enterprise zodat partitionering en historie al aanwezig zijn.
- Bedrijfsresultaat: één dashboard toont GPU's en netwerk samen. Als een job vertraagt, kan het team binnen minuten zien of een GPU, een server of een poort de oorzaak is, in plaats van een supportcase te openen en te wachten.
- Voorbeeld: de doorvoer van een finetuningjob zakt elke middag met een vijfde. Het fabricpaneel toont oplopende foutherstelaantallen op één poort naarmate de ruimte opwarmt. De oorzaak is een temperatuurgevoelige transceiver; die wordt onder garantie vervangen voordat hij volledig uitvalt.
2. Een cluster van 32 nodes in SuperPOD-stijl
Tweeëndertig servers met elk acht GPU's, 256 GPU's, gebouwd op het referentieontwerp van NVIDIA met aparte netwerkrails, leaf- en spineswitches en ruim duizend optische links. Meerdere teams trainen er grote modellen op, en sommige jobs gebruiken alle GPU's tegelijk.
- Ons gebruikelijke advies: UFM Enterprise in een HA-paar, met partities per team, de plugin voor probleemdetectie eerst ingeschakeld in dry-runmodus en de telemetrie die naar centrale monitoring stroomt. Evalueer UFM Cyber-AI zodra er een paar maanden historie is: op deze schaal is een handvol falende kabels per kwartaal normaal, en die voorspellen levert geld op.
- Bedrijfsresultaat: storingen die vroeger aan de oppervlakte kwamen als "de grote job is traag", worden een ticket dat zegt welke kabel, welk rack en welke jobs erlangs liepen. Onderhoud verschuift van noodgeval naar gepland.
- Voorbeeld: een link tussen een leaf en een spine begint twee keer per uur te flapperen. Alerting roept de on-call-engineer binnen ongeveer vijf minuten op, de plugin voor probleemdetectie van UFM isoleert de poort zodat het verkeer eromheen wordt gerouteerd, en de job van 256 GPU's loopt door met een fractie van een procent minder bandbreedte in plaats van vast te lopen. De kabel wordt de volgende ochtend vervangen.
3. Een universitaire HPC-dienst met Slurm
Een gedeeld onderzoekscluster: een paar generaties GPU-nodes, een grote pool CPU-nodes, een parallel bestandssysteem en honderden gebruikers uit verschillende faculteiten, allemaal gepland via Slurm.
- Ons gebruikelijke advies: UFM Enterprise met de Slurm-integratie van NVIDIA, die elke job tijdens het draaien een eigen fabricpartitie kan geven, zodat jobs van verschillende groepen zowel op het netwerk als op de servers van elkaar zijn geïsoleerd. GPU-metrics worden getagd met de Slurm-job-ID, zodat het gebruik herleid kan worden tot een job, een gebruiker en een afdeling.
- Bedrijfsresultaat: eerlijke, onderbouwde rapportage. Het research-computingteam kan elke afdeling haar GPU-uren laten zien, hoe efficiënt die zijn gebruikt en of trage jobs aan de code of aan de infrastructuur lagen. Dat maakt financieringsaanvragen, doorbelasting en capaciteitsplanning veel eenvoudiger.
- Voorbeeld: een promovendus meldt dat haar job van acht nodes "op dinsdag altijd traag is". De jobweergave laat zien dat haar nodes een leafswitch delen met een wekelijkse data-ingestjob die de uplinks verzadigt. De oplossing is een schedulerbeperking, geen nieuwe hardware.
Wat goed zicht op de fabric u oplevert
- Hogere GPU-bezetting, omdat netwerkstoringen in minuten worden gevonden in plaats van dagen, en jobs niet blijven wachten op één slechte poort.
- Minder mislukte lange runs, omdat falende kabels en transceivers worden opgemerkt en in geplande vensters worden vervangen.
- Snellere, rustigere incidenten, omdat GPU-, server-, netwerk- en jobdata op één tijdlijn staan, zodat de eerste vraag ("is het het netwerk?") met bewijs wordt beantwoord.
- Zuivere multitenancy, omdat partities en isolatie per job centraal worden beheerd en geauditeerd.
- Eerlijke capaciteits- en kostenrapportage, omdat u de kosten per nuttig GPU-uur per team kunt tonen, in plaats van de kosten per geïnstalleerde GPU.
- Sterkere garantie- en supportcases, omdat u de leverancier de tellers, tijdstempels en historie van een defect onderdeel kunt geven in plaats van een beschrijving.
Monitor de hele stack, niet alleen de fabric
UFM bestrijkt de InfiniBand-fabric. Een werkend AI-cluster heeft ook zicht nodig op de GPU's (Data Center GPU Manager van NVIDIA, DCGM), de Ethernet-netwerken voor opslag- en front-endverkeer (NVIDIA Spectrum-X en NetQ), BlueField-data processing units als u die gebruikt, de servers, de scheduler en de AI-diensten zelf. In ons eerdere bericht over observability als bedrijfsstandaard betoogden wij dat monitoring één bedrijfsbreed contract moet zijn, geen verzameling teamvoorkeuren. Hetzelfde geldt hier: fabricdata hoort in hetzelfde systeem als al het andere, op dezelfde manier gelabeld, zodat één query een trage job kan volgen van de scheduler naar de GPU naar de switchpoort.
Ons standaardontwerp gebruikt OpenTelemetry om alles één keer te verzamelen en naar twee soorten backends te sturen: Prometheus-compatibele metrics met Grafana (wij gebruiken Grafana Mimir voor langdurige, hoog beschikbare opslag en Grafana Tempo voor request traces), en de Elastic-stack (Elasticsearch en Kibana) voor logs en events, omdat veel organisaties die al draaien. Als u al op een van beide hebt gestandaardiseerd, sluiten wij aan op wat u hebt.
Wat Workstation doet
Wij zijn een Britse reseller en integrator van NVIDIA AI-infrastructuur, en wij verzorgen beheerde observability voor klanten. Voor een door UFM beheerd cluster betekent dat drie dingen:
- Levering. GPU-servers (DGX- en HGX B300-systemen en andere), InfiniBand- en Ethernet-switches, adapters, kabels en transceivers, en de UFM-licenties op het juiste niveau, samen gespecificeerd zodat de fabric bij de GPU's past. U kunt DGX-systemen, netwerkapparatuur en NVIDIA-software in onze shop bekijken.
- Inrichting. Wij installeren UFM (in een HA-paar waar dat past), configureren partities en de Slurm- of Kubernetes-integratie, rollen DCGM en de OpenTelemetry-collectors uit, en dragen dashboards en alertregels over die tegen echte storingen zijn getest: wij trekken een kabel los en laten u de page zien binnenkomen.
- Beheer voor u. Onze beheerde observabilitydienst houdt de monitoringstack zelf gezond en hoog beschikbaar, stemt alerts af zodat ze het waard zijn om voor wakker te worden, bewaakt dag en nacht de gezondheid van fabric en GPU's en stuurt u maandelijks een rapport over bezetting, storingen en capaciteit. Wij werken samen met uw team en met NVIDIA-support, niet in plaats van hen.
Vragen om te stellen voordat u koopt
- Wie wordt dagelijks eigenaar van de fabric, en moet die hem beheren of alleen zien?
- Wordt het cluster gedeeld tussen teams, afdelingen of klanten? Zo ja, hoe worden die op het netwerk van elkaar geïsoleerd?
- Welke scheduler gebruikt u, en wilt u GPU- en fabricgebruik per job en per team gerapporteerd zien?
- Waar moet de monitoringdata staan, en hoe lang? Draait u al Prometheus, Grafana of Elastic?
- Wat kost een uur van uw cluster, en hoe snel moet u weten wanneer het wordt verspild?
NVIDIA-partner: engineering, software en mensen
Workstation is een NVIDIA-partner. Naast het leveren van de hardware bieden wij de engineering, software en medewerkers om AI-datacenters te plannen, te bouwen en te beheren: locatie- en stroomonderzoeken, rack- en fabricontwerp, installatie van InfiniBand en Spectrum-X, inrichting van UFM, DCGM en OpenTelemetry, onboarding van Kubernetes en Slurm, en engineers die bij u blijven tijdens de overdracht en het beheer. Voor de eigen beschrijving van het platform door NVIDIA, zie de officiële pagina NVIDIA Unified Fabric Manager (UFM) (opent in een nieuw tabblad).
Volgende stappen
Open de interactieve dashboardgalerij om de zeventien overzichten te zien die wij voor een typisch cluster bouwen, van fabricgezondheid tot kosten per GPU-uur. Vraag daarna onze AI Sales Engineer om een cluster, een fabric en het juiste UFM-niveau voor uw workloads te dimensioneren, of bekijk in de Workstation-shop de configuraties voor HGX B300-servers en DGX BasePOD. Wij beginnen graag met een observabilityreview van een cluster dat u al bezit.
De cijfers in dit bericht zijn illustratieve voorbeelden, geen metingen bij een specifieke klant.
Erkenning van rechten: NVIDIA, het NVIDIA-logo, DGX, HGX, Quantum, Spectrum, Spectrum-X, BlueField, ConnectX, NVLink, DOCA, DCGM en Unified Fabric Manager (UFM) zijn handelsmerken en/of geregistreerde handelsmerken van NVIDIA Corporation in de Verenigde Staten en andere landen. NVIDIA-producten en -technologieën kunnen worden beschermd door octrooien en andere intellectuele-eigendomsrechten van NVIDIA Corporation, en al die rechten worden erkend en voorbehouden aan hun eigenaren. Productinformatie is in onze eigen woorden samengevat uit openbare documentatie van NVIDIA; de website en documentatie van NVIDIA zijn de gezaghebbende bron. Andere bedrijfs- en productnamen, waaronder Prometheus, Grafana, Elasticsearch, Kibana, Logstash, OpenTelemetry, Kubernetes en Slurm, kunnen handelsmerken zijn van hun respectieve eigenaren. De eigen dashboards, configuraties en teksten van Workstation zijn © Workstation.