Observability is niet optioneel: maak er een bedrijfsstandaard van
Voor managers en eigenaren: centraliseer telemetrie, standaardiseer platforms en behandel monitoring als releasevereiste — niet als teamvoorkeur
 Balinder Walia8 oktober 20263 min read
Voor managers en ondernemers: observability is geen toolvoorkeur — het is de manier waarop het bedrijf weet of producten, betalingen en AI-agents gezond zijn. Maak er een gecentraliseerde standaard van, geen optioneel zijproject. Technische aanvulling: Big Prometheus, voor- en nadelen, en MoSCoW van het toollandschap. Gerelateerd: LLM-knelpunten & kostenbeheersing.
Waarom dit een bedrijfsbeslissing is, geen SRE-hobby
Als een checkout om 2 uur ’s nachts faalt, vraagt de leiding niet welke opensource-database een benchmark heeft gewonnen. Ze vraagt: hoe lang duurt het voordat we het weten, hoe lang voordat het is opgelost, en hoe voorkomen we herhaling? Die antwoorden bestaan alleen als metrics, logs, traces en alerts in een gedeeld systeem met duidelijk eigenaarschap staan.
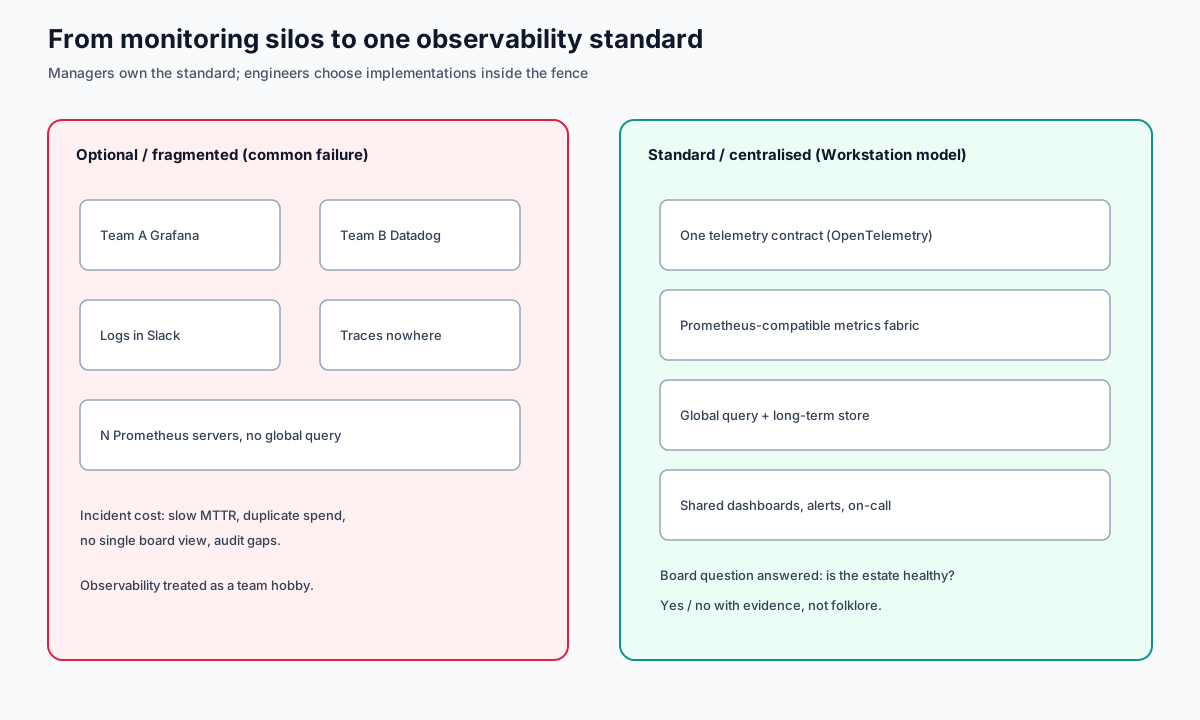
Optionele observability leidt tot voorspelbare faalpatronen:
- Blinde vlekken — een kritieke service “had geen tijd” om metrics toe te voegen.
- Toolwildgroei — drie APM's, twee logproducten, geen enkele bron van waarheid voor SLO's.
- Kostenverrassingen — labels met hoge kardinaliteit en ongesamplede traces blazen budgetten op.
- Gaten in audits — toezichthouders en zakelijke klanten vragen om bewijs; screenshots uit Slack tellen niet.
Wat “gecentraliseerd en standaard” in de praktijk betekent
Gecentraliseerd betekent niet voor altijd één leverancier. Het betekent:
- Eén telemetriecontract — elke productieservice stuurt metrics, logs en traces uit in goedgekeurde formaten (doorgaans OpenTelemetry + Prometheus).
- Eén plek voor vragen over het hele landschap — “welke clusters staan in brand?” en “wat was het foutpercentage zeven weken geleden?” zonder tussen tien UI's te springen.
- Eén taxonomie voor on-call en alerts — ernst, eigenaarschap en escalatie zijn gedeelde taal.
- Eén FinOps-teugel — retentie, sampling en kardinaliteitsbudgetten zijn beleid, geen heldendaden.
Geïnspireerd door de opensource-discussie over “Big Prometheus” (Thanos, Cortex/Mimir, M3, VictoriaMetrics) is de technische keuze hoe u die standaard over veel Kubernetes-clusters opschaalt — niet of u überhaupt een standaard nodig hebt.
MoSCoW in één slide voor de leiding
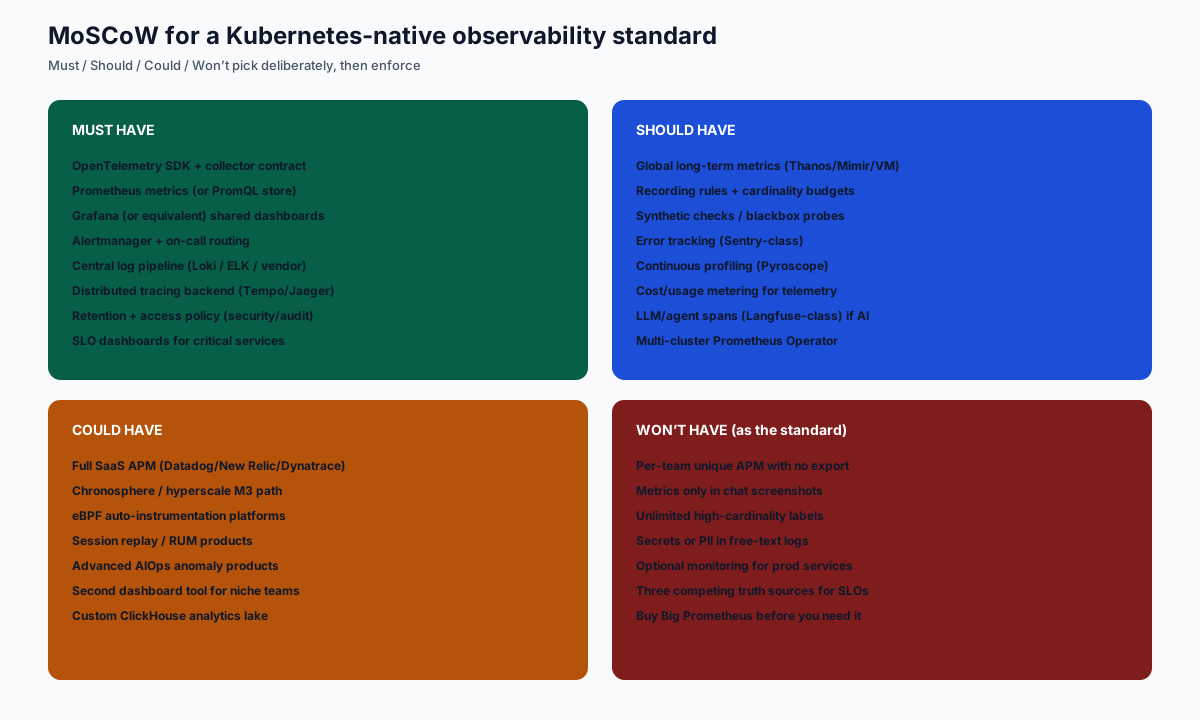
- Must — OpenTelemetry-contract, PromQL-metrics, gedeelde dashboards, alerting/on-call, centrale logs, tracing, retentie- en toegangsbeleid, SLO's voor kritieke klantreizen.
- Should — wereldwijde opslag voor metrics op lange termijn, kardinaliteitsbudgetten, synthetische tests, error tracking, profiling, kostenmeting van telemetrie.
- Could — volledige SaaS-APM, commerciële stacks op hyperscale, eBPF-auto-instrumentatie, RUM/session replay.
- Won’t (als standaard) — unieke APM's per team zonder export, metrics als screenshots, onbeperkte kardinaliteit, optionele monitoring voor productie, drie concurrerende SLO-bronnen.
Wat managers moeten financieren en afdwingen
- Platformeigenaarschap — een klein team is eigenaar van de standaard; productteams gebruiken die.
- Definition of Done — geen productierelease zonder golden signals en runbooks die aan alerts zijn gekoppeld.
- Budget als beleid — betaal bewust voor retentie en queryprestaties; “bespaar” niet door blind te gaan.
- Kwartaalreviews — toolwildgroei, trends in MTTA/MTTR en de grootste kardinaliteitsveroorzakers.
Het standpunt van Workstation
Workstation draait GPU-webwinkels, AI-agents, edge-proxy's en promotieringen. Die omgevingen blijven alleen betrouwbaar als observability verplicht is over INT → TEST → ACC → PROD — dezelfde discipline die we toepassen op secrets en releases. Voor de technische verdieping — Big Prometheus-opties, eerlijke voor- en nadelen en een volledige MoSCoW van het toollandschap — leest u het technische artikel.
Wilt u één observability-standaard voor al uw clusters en AI-workloads? Neem contact op met Workstation.