NVIDIA NVKE en NVKR: waarom GPU-Kubernetes het besturingssysteem van de AI-fabriek wordt
Wat NVIDIA op KubeCon 2026 open source maakte, waarom het belangrijk is en wat het betekent voor developers en DevOps-engineers
 Balinder Walia14 november 20269 min read
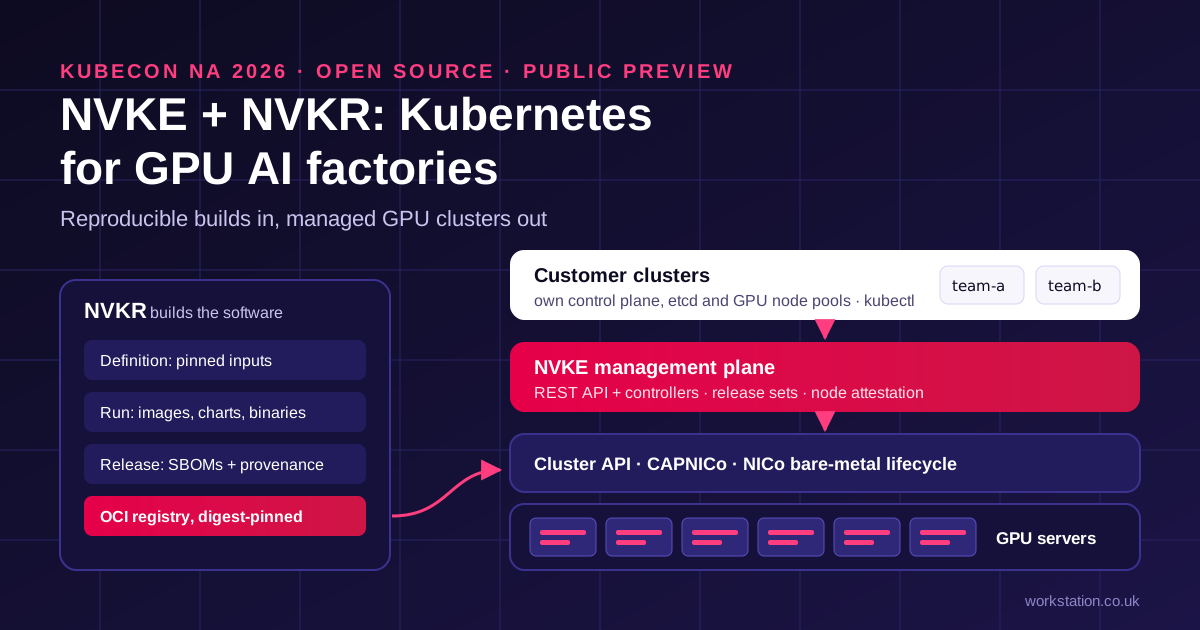
Op KubeCon North America op 10 november 2026 maakte NVIDIA twee projecten open source: NVIDIA Kubernetes Engine (NVKE) en NVIDIA Kubernetes Recipes (NVKR). Op het eerste gezicht zijn het gewoon wat meer Kubernetes-tools. Het grotere verhaal is de richting die ze aangeven: GPU-capaciteit wordt steeds vaker via Kubernetes afgenomen, en iemand moet die clusters bouwen, beheren en upgraden. Dit bericht legt in gewone taal uit wat de twee projecten doen, waarom ze belangrijk zijn, wat ze betekenen voor developers en DevOps-engineers, en wie er nu naar moet kijken.

Wat NVIDIA aankondigde
NVIDIA publiceerde beide projecten op GitHub onder de organisatie DSX AI Factory, samen met een uitgebreide walkthrough op de NVIDIA Technical Blog. Ze zijn onderdelen van het NVIDIA DSX AI Factory Platform, het referentieontwerp van NVIDIA voor het bouwen en beheren van GPU-datacenters.
- NVKE (NVIDIA Kubernetes Engine) is een managementplane. U installeert het één keer, op een klein cluster van uw eigen servers, en het maakt en beheert aparte Kubernetes-clusters voor uw klanten. Elk klantcluster krijgt een eigen control plane, een eigen etcd-database en eigen GPU-nodepools. U beheert ze via een API en een commandlinetool genaamd
nvkectl; uw klanten gebruiken hun clusters met gewonekubectl. - NVKR (NVIDIA Kubernetes Recipes) is een build- en releasesysteem. Het neemt een gedeclareerde set softwareversies, bouwt de besturingssysteemimages voor nodes, containerimages, Helm-charts en binaries, en legt precies vast wat er in elk ervan zit, met software bills of materials (SBOM's), herkomstgegevens en handtekeningen die u tegen uw eigen beleid kunt verifiëren.
De twee kunnen samen of los van elkaar worden gebruikt. NVKE is tijdens runtime niet afhankelijk van NVKR, en NVKR kan artifacts bouwen voor andere Kubernetes-beheersystemen. NVIDIA meldt dat NVKE een Certified Kubernetes AI Platform en Certified Kubernetes Installer is, met conformiteitstests op Kubernetes 1.36.
NVIDIA noemde ook early adopters. NVIDIA Cloud Partners Firmus en SK Telecom integreren NVKE en NVKR in hun AI-fabrieken, en Mirantis, Rafay, Spectro Cloud, OpenNebula Systems en vCluster integreren componenten in hun beheerde Kubernetes-producten, terwijl Netris NVKE ondersteunt in zijn netwerkautomatisering.
Waarom dit belangrijker is dan zomaar een Kubernetes-tool
Vijf jaar geleden betekende "GPU-infrastructuur" een paar servers onder een bureau en een gedeelde login. Tegenwoordig willen de mensen die GPU-capaciteit afnemen, of het nu een onderzoeksgroep, een productteam of een externe klant is, die steeds vaker op dezelfde manier als al het andere: als een Kubernetes-cluster waar ze hun bestaande tools op kunnen richten. Dat is een redelijk verzoek. Het is ook een lastige dienst om te leveren. Achter "geef mij een cluster met vier GPU-nodes" zit een lange lijst taken:
- vrije servers vinden en ze opstarten met het juiste besturingssysteem, de juiste drivers en agents;
- zeker weten dat een server echt van u is voordat hij aan iemands cluster wordt toegevoegd;
- het cluster van de ene klant geïsoleerd houden van dat van de volgende;
- Kubernetes en de node-images upgraden zonder lopende trainingsjobs te breken;
- precies weten welke softwareversies op elke node staan als er iets misgaat, en ze later identiek opnieuw bouwen;
- en dat allemaal kwalificeren tegen meerdere generaties GPU's en meerdere versies van Kubernetes.
Grote publieke clouds hebben dit intern opgelost, met grote interne teams. NVKE en NVKR zijn de poging van NVIDIA om dezelfde bouwstenen te geven aan iedereen die GPU's draait: gespecialiseerde GPU-clouds, telecombedrijven, soevereine AI-fabrieken, universiteiten en organisaties met eigen racks. Het interessante signaal is niet dat NVIDIA een Kubernetes-installer heeft geschreven. Het is dat het bedrijf dat de GPU's maakt, het beheren ervan via Kubernetes nu als onderdeel van het product beschouwt.
Hoe het werkt, in vier stappen

- Bouwen. NVKR bouwt de node-image (een schijfimage met Kubernetes, de netwerkstack en de node-agents geïnstalleerd), de image van de NVKE-controller, de Helm-chart ervan en de tool
nvkectl, allemaal uit bronnen met vastgepinde versies. - Bootstrappen.
nvkectlstart een klein tijdelijk cluster op een bootstrapmachine. Dat tijdelijke cluster vraagt NVIDIA Infra Controller (NICo), de bare-metal-provisioningdienst van NVIDIA, om drie servers, start ze op vanaf de node-image en draagt het werk aan ze over. De drie servers worden het permanente managementcluster en het tijdelijke cluster wordt verwijderd. - Publiceren wat klanten mogen draaien. De operator publiceert "release sets": een benoemde, geteste combinatie van machine-image, Kubernetes-versie en nodeconfiguratie. Klanten kiezen een release op naam; ze hebben nooit te maken met besturingssysteemimages of bootscripts.
- Clusters aanmaken. Een klantcluster is één kort YAML-verzoek: Kubernetes-versie, drie control-planeservers, een GPU-nodepool van een bepaalde grootte. NVKE richt het in, en de operator geeft de klant een kubeconfig.
Twee ontwerpkeuzes vallen op. Ten eerste moet elke node zijn identiteit bewijzen, met zijn hardwarebeveiligingschip (TPM) en het identiteitsframework SPIFFE/SPIRE, voordat hij credentials krijgt om aan een cluster deel te nemen. Ten tweede gebruikt NVKE de standaard Kubernetes Cluster API om met de infrastructuur te praten, zodat de provisioninglaag een goed begrepen open interface is in plaats van een black box. Onze technote loopt elke stap door met de commando's, de configuratie en de vastgepinde versies.
Wat "public preview" hier echt betekent
NVIDIA is ongewoon direct over de huidige beperkingen, en die doen ertoe voor iedereen die een dienst plant:
- Na de installatie draait de NVKE API over gewoon HTTP met authenticatie uitgeschakeld. U moet zelf het netwerk afschermen, authenticatie inschakelen en er TLS voor zetten.
- NVKE doet geen autorisatie: elke geauthenticeerde aanroeper kan het cluster van elke klant aanmaken of verwijderen.
- Het managementcluster upgradet, schaalt of herstelt zichzelf niet, en er is nog geen gedocumenteerde procedure voor upgrade of voor back-up en restore ervan.
- Klanten ontvangen een beheerders-kubeconfig die niet kan worden ingetrokken totdat het certificaat verloopt.
- NICo is de standaard (en in de praktijk de belangrijkste) manier om machines te krijgen.
- Nog geen enkele NVKR-release is "gekwalificeerd", en de node-images met volledige schijfversleuteling zijn alleen bedoeld voor evaluatie.
Niets hiervan is verrassend voor een eerste publieke release, en de openbare roadmaps laten zien waar het naartoe gaat. Maar het betekent wel dat NVKE vandaag iets is om te evalueren, niet iets om een serviceniveau op te verkopen.
De les voor developers en DevOps-engineers
Er leeft een populair idee dat AI-engineering cloud- en DevOps-werk vervangt. Aankondigingen als deze wijzen op het tegendeel. AI stelt nieuwe, zwaardere eisen aan precies die vaardigheden.
Weten hoe u een groot taalmodel via een API aanroept, is nuttig. Het is ook het deel dat het makkelijkst te leren en het makkelijkst te automatiseren is. De technische diepgang zit in begrijpen hoe AI-systemen in productie draaien, schalen en falen:
- GPU-bewuste scheduling. Hoe Kubernetes GPU-workloads plaatst, hoe nodepools per GPU-generatie eruitzien, en waarom een idle GPU in een "running" job de duurste bug is die u ooit zult opleveren.
- Onveranderlijke, reproduceerbare infrastructuur. Het hele uitgangspunt van NVKR is dat u precies moet kunnen zeggen wat er op een node staat en hem byte voor byte opnieuw moet kunnen bouwen. Dat is DevOps en supply-chainbeveiliging, toegepast op GPU-vloten.
- Identiteit en isolatie. Hardware-attestatie, etcd-versleuteling per cluster, netwerkisolatie tussen tenants en zorgvuldige omgang met credentials zijn vaardigheden op het gebied van platformbeveiliging, geen data-sciencevaardigheden.
- Levenscyclus en upgrades. Een nieuwe Kubernetes-versie of driver uitrollen over GPU-nodes zonder een trainingsrun van een week om zeep te helpen, is een plannings- en automatiseringsprobleem.
- Observability. NVKE levert een telemetriepipeline op basis van OpenTelemetry. Iemand moet nog steeds beslissen wat er wordt gemeten, waar het naartoe gaat en wat een mens wakker maakt.
Als u een developer bent die de overstap naar AI maakt, maakt kennis van hoe deze clusters worden gebouwd en beheerd u veel nuttiger dan nog een cursus prompt engineering. Als u al platform- of DevOps-engineer bent, worden uw vaardigheden niet overbodig; ze staan op het punt gevraagd te worden voor een nieuwe en veel duurdere klasse hardware.
Worden GPU-gerichte Kubernetes-platforms een belangrijk onderdeel van enterprise-AI?
Onze visie: ja, maar niet op de manier die de koppen misschien suggereren. De meeste organisaties zullen NVKE niet zelf installeren. Waarschijnlijk is dat de aanbieders bij wie ze GPU-capaciteit inkopen, gespecialiseerde GPU-clouds, telecombedrijven, soevereine AI-programma's en managed service providers, op iets vergelijkbaars standaardiseren, omdat het de kosten verlaagt van het aanbieden van "Kubernetes met GPU's" als dienst. Organisaties zullen het effect merken als consistentere, beter overdraagbare GPU-clusters, waar ze die ook huren of draaien.
Voor organisaties die wel hun eigen GPU-racks draaien, is de case het sterkst wanneer u meerdere teams of klanten bedient vanuit één pool hardware. Eén team op één cluster is vandaag meestal beter af met een volwassen, ondersteunde Kubernetes-distributie, terwijl het de discipline van NVKR overneemt: vastgepinde, ondertekende, reproduceerbare node-images.

Wie nu naar NVKE en NVKR moet kijken
| U bent | Wat u nu doet |
|---|---|
| Een GPU-cloud, hostingprovider of telecombedrijf dat Kubernetes aan klanten aanbiedt | Evalueer NVKE serieus. Draai de lokale quickstart, daarna een lab op reservehardware met NICo, en zet elke beperking van de preview af tegen uw servicetoezeggingen. |
| Een organisatie of universiteit die een GPU-pool tussen afdelingen deelt | Draai de lokale quickstart en volg de roadmap. Begin nu met vastgepinde, ondertekende node-images, welke installer u ook gebruikt. |
| Eén team met één GPU-cluster | Houd uw huidige distributie. Neem de ideeën van NVKR over reproduceerbare builds en SBOM's over. |
| Nog geen GPU's in gebruik | Leer het beheermodel eerst op een geleaset of beheerd GPU-cluster; de vaardigheden zijn direct overdraagbaar. |
De lokale quickstart heeft alleen een Linux-host of virtuele machine nodig met minimaal 6 CPU's, 12 GiB vrij geheugen en 100 GiB vrije schijfruimte, plus Docker en ondersteuning voor een virtuele TPM. Er is geen GPU en geen NVIDIA-account nodig, dus er is weinig reden voor een platformteam om het niet te proberen.
Wat Workstation doet
Wij ontwerpen, leveren en beheren GPU-infrastructuur voor Britse organisaties, en Kubernetes is de manier waarop de meeste van onze klanten die afnemen.
- Private GPU-clouds. Wij plannen en bouwen private GPU-clouds vanaf nul: servers, netwerk, opslag en de Kubernetes-laag erbovenop, gedimensioneerd met onze VRAM- en readinesstools.
- Kubernetes-platforms voor AI. Wij richten GPU-ready Kubernetes, GitOps-delivery en MLOps-pipelines in (zie onze berichten over uw eigen LLM's draaien op Kubernetes en Kubeflow en Argo CD), en wij kunnen u helpen een evaluatie van NVKE en NVKR op uw eigen hardware te plannen.
- Leasen in plaats van kopen. Als kapitaal de beperkende factor is, vergelijkt gpuleasing.co.uk leasen en kopen van GPU-servers voor uw workload.
Volgende stappen
- Lees de technote over NVKE en NVKR voor de volledige workflow, configuratie, vastgepinde versies en een hardeningchecklist voor de preview.
- Probeer de lokale quickstart uit de NVKE-repository en bekijk de NVKR-repository.
- Vraag onze AI Sales Engineer om een GPU-cluster voor uw workloads te dimensioneren, of praat met ons over een Kubernetes-platform voor uw GPU's.
Feiten over NVKE en NVKR zijn ontleend aan de aankondiging van NVIDIA en de openbare documentatie van de projecten per 14 november 2026. Beide zijn in public preview, en hun API's en gedrag kunnen tussen releases veranderen.
Erkenning van rechten: NVIDIA, het NVIDIA-logo en DSX zijn handelsmerken en/of geregistreerde handelsmerken van NVIDIA Corporation in de Verenigde Staten en andere landen. Kubernetes is een geregistreerd handelsmerk van The Linux Foundation. Andere genoemde product- en bedrijfsnamen zijn eigendom van hun respectieve eigenaren. Al die rechten worden erkend en voorbehouden aan hun eigenaren.