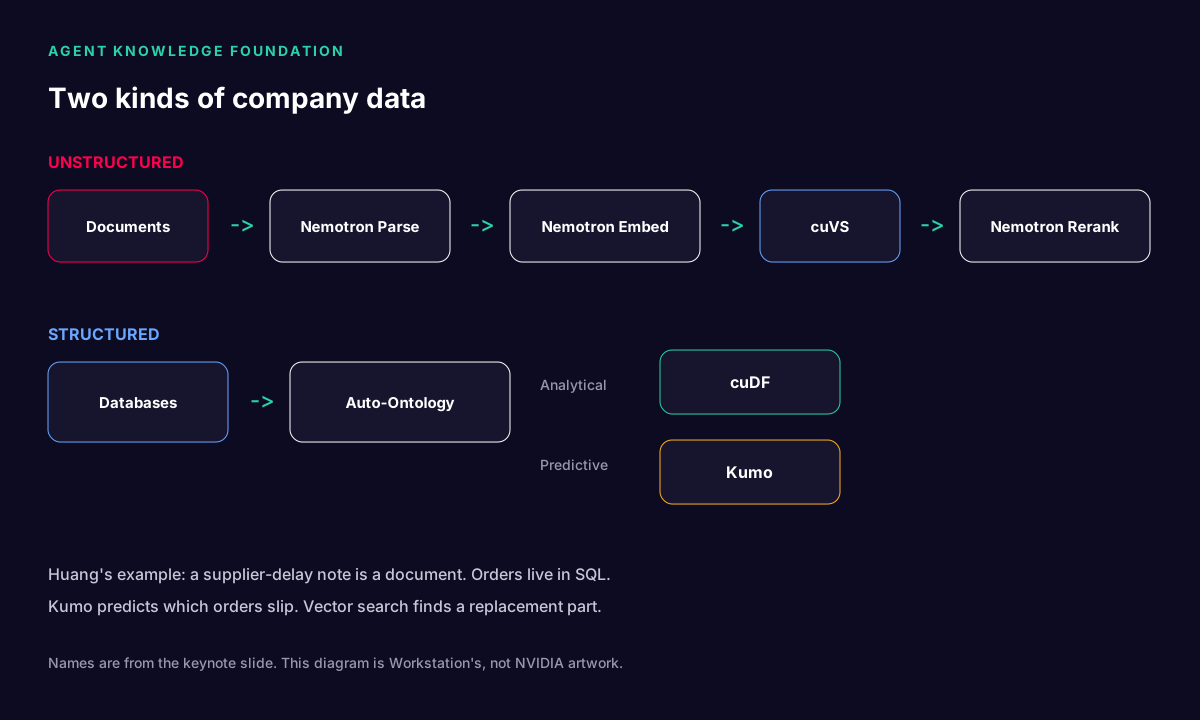
Na de sandbox richtte de keynote van Jensen Huang op GTC Berlin zich op datgene wat een agent specifiek maakt voor één bedrijf: zijn kennis. De slide achter hem was de Agent Knowledge Foundation. Ongestructureerde documenten volgen één pad. Gestructureerde databases volgen een ander. Dit artikel volgt die slide en daarna de partnervoorbeelden die hij gebruikte voor het post-trainen van Nemotron, zonder er een als casestudy van Workstation te behandelen.
Waarom een basismodel niet het geheugen van de agent is
De volgorde van onderdelen bij Huang was bewust. Eerst de harness, draaiend in een OpenShell-sandbox. Ten tweede Nemotron als taalmodel. Die twee, zei hij, zijn slechts het begin. Wat van een agent iets maakt dat hij een super agent noemde, is toegang tot de eigen kennis van het bedrijf. De bibliotheken en modellen voor die taak zijn wat NVIDIA op één slide zette en de Agent Knowledge Foundation noemde.
Bedrijfsdata komt in twee vormen. Documenten, pdf's en andere bestanden die een AI moet lezen. En rijen in een database. Het fundament is de set bibliotheken die uit beide betekenis halen.
Het documentpad
Van links naar rechts op de ongestructureerde rij van de slide:
- Nemotron Parse leest de documenten. Huang noemde het van wereldklasse en "top of leaderboard". Hij noemde het leaderboard niet. Wij gaan er geen verzinnen.
- Nemotron Embed zet een query en de geparste kennis om in vectoren, zodat ze aan elkaar kunnen worden gekoppeld. Hij gebruikte dezelfde formulering "top of leaderboard".
- cuVS is de vector search. De slide zet het tussen Embed en Rerank. cuVS is de bibliotheek van NVIDIA voor similarity search op de GPU.
- Nemotron Rerank neemt de vele passages die de zoekopdracht oplevert en ordent ze op relevantie voor de vraag.
Dat is een retrieval-pipeline, getekend als productnamen in plaats van als een generiek "RAG"-blok. Parsen, embedden, zoeken, herordenen. De agent moet nog steeds toestemming hebben om het aan te roepen. In het beeld met vijf elementen is deze hele rij het kenniselement, bereikt via een tool die het sandboxbeleid toestaat.
Het databasepad
De gestructureerde rij begint bij Auto-Ontology en splitst zich dan.
- Analytisch werk gaat naar cuDF, de GPU-dataframebibliotheek.
- Voorspellend werk gaat naar Kumo. Het transcript van de keynote geeft deze naam weer als "QMO" en "CUMA". De slide in de zaal spelt het als Kumo. Wij volgen de slide.
Het voorbeeld van Huang is het voorbeeld om te onthouden, omdat het beide rijen gebruikt. Een bericht dat een leverancier tekort zal komen of te laat zal zijn, komt binnen als document. De orders die die leverancier bedient, staan in SQL. Kumo is volgens hem hoe u voorspelt welke orders uitlopen, en met hoeveel. Een vervangend onderdeel vinden is een vector search terug in de engineeringdocumenten. Eén beslissing, twee datavormen, twee tools.
Open gewichten, daarna uw data
Vóór de slide pleitte Huang voor open modellen die u kunt inspecteren. Nemotron voor taal. Cosmos als world foundation model. GR00T voor humanoïde robotica. Alpamayo voor autonoom rijden. Earth-2 voor fysica. Hij zei dat NVIDIA de gewichten publiceert, de data waarmee het model is gebouwd en de scripts om het te reproduceren, zodat een lab de herkomst kan zien. "Providence" in het ruwe transcript is provenance, herkomst.
Hij was ook direct over de rangorde. Deze taalmodellen zijn niet automatisch de frontier der frontiers. Aanpassing, met partners, is volgens hem hoe u ze verandert in een frontier-model voor één taak, en bedrijfseigen data omzet in wat hij soevereine intelligentie noemde. "Super intelligence" later in dezelfde passage is zijn term voor het resultaat van die post-training. Het is een bewering over geschiktheid voor een taak, geen gemeten IQ.
De voorbeelden die hij vanaf het podium noemde, volgens het gepubliceerde transcript, waren de volgende. We hebben de klantopdrachten niet geverifieerd, behalve het feit dat hij ze noemde:
- A21 die Alice helpt, door Nemotron om te vormen tot een model dat volgens hem op hun taak de frontier-capaciteit overtreft.
- Base10 die CodeRabbit helpt, door Nemotron te finetunen op de data van die klant.
- Trajectory en Harvey, die Nemotron post-trainen.
- Scale die met Skydance werkt, volgens hetzelfde patroon.
- Palantir met Tampa General Hospital.
Het neocloud-wiel later in de keynote spelt een bedrijf als Baseten. Het transcript van deze passage zegt Base10. We voegen die niet samen tot één bedrijf. Als u CodeRabbit, Harvey, Skydance of Tampa General bent: de zin hierboven is die van Huang, geen resultaat dat wij hebben gereproduceerd.
Tools zijn het laatste element
Kennis zonder tools laat de agent nog steeds een lezer. De laatste stap van Huang was CUDA-X: domeinbibliotheken die worden gebruikt in wetenschap, engineering, onderzoek en creatief werk. Hij noemde ze de kroonjuwelen, omdat een assistent die ontwerpt of rekent een algoritme moet aanroepen, niet alleen een chat-API. De RTX Spark-demo later in de keynote vatte dat in één adem samen: Hermes als harness, Nemotron en een model dat het transcript "OpenAI's GPT-6 Astra" noemt, en CUDA-X-tools waaronder FreeCAD, Blender, Isaac Sim, de Newton-physics-engine en Isaac Lab. Die demo was van NVIDIA, op het podium, voor een Hugging Face-robot genaamd Microduck. Het is geen benchmark van Workstation.
Wat u eerst bouwt
Als u een agent uitrust met uw eigen bestanden, is de slide uit Berlijn een checklist in plaats van een inkooporder.
- Zet de harness in een sandbox voordat u hem aan de bestandsopslag koppelt. Het OpenShell-artikel is die helft.
- Bepaal welke kennis een document is en welke een tabel. Stuur niet beide door dezelfde pipeline in de hoop dat het goed gaat.
- Parse en embed de documenten. Zoek met een vectorbibliotheek. Herorden voordat het model de stapel ziet.
- Houd SQL als SQL. Gebruik een dataframebibliotheek voor analyse en een voorspellend model alleen waar u een vraag hebt zoals het leveranciersvoorbeeld van Huang.
- Post-train een open model alleen wanneer het generieke model fout zit op een manier die uw data kan oplossen. Hij zei dat de technologie bestaat. Hij zei niet dat het goedkoop is of dat elke finetune wint.
Het leveranciersvoorbeeld stap voor stap
Zet het verhaal van Huang in de volgorde waarin een systeem het daadwerkelijk zou uitvoeren.
- Een pdf of e-mail meldt dat een leverancier te laat zal zijn. Dat bestand komt bij Nemotron Parse.
- Nemotron Embed zet het vertragingsbericht, en de query "welke orders raakt dit?", om in vectoren.
- cuVS doorzoekt de vector store. Nemotron Rerank houdt de passages over die echt over die leverancier gaan.
- Het orderboek staat niet in die store. Het is SQL. Auto-Ontology is de naam op de slide voor het leesbaar maken van die gestructureerde wereld voor de agent. cuDF is de analytische stap over die rijen. Kumo is de voorspellende stap: wie komt tekort, en hoe lang.
- Een vervangend onderdeel is weer ongestructureerd: een tekening of een specificatie. De zoekopdracht levert het op. De harness stelt een actie voor. De sandbox beslist of die actie is toegestaan.
Sla stap 5 over en u hebt een belezen model met een shell. Dat is de fout waarvoor OpenShell bestaat.
Wanneer u niet moet post-trainen
De partnerlijst van Huang is een lijst van teams die al een taak en data hadden. Het is geen reden om op dag één te finetunen. Als het generieke model fout zit omdat het uw bestanden niet kan zien, los dan eerst de retrieval op. Als het de bestanden wel kan zien en nog steeds de verkeerde termen, de verkeerde eenheden of het verkeerde beleid gebruikt, dan is post-training de stap die hij beschreef: begin bij Nemotron, bewaar het recept zodat u weet wat u hebt veranderd, en test op uw eigen traces. Hij zei dat het resultaat voor die taak de frontier kan bereiken. Hij publiceerde de scores niet. Wij ook niet.
CUDA-X is de toolplank daaronder. Hij zei dat één computer vloeistofdynamica, deeltjesfysica, kwantumchemie, dataverwerking en ray tracing draait, en dat het GPU-pad in de orde van 10, 50 of 100 keer een native CPU-run ligt. Die bandbreedte werd op het podium uitgesproken. Het is geen enkele benchmark met een benoemde dataset. Gebruik het als zijn argument waarom tools op een GPU thuishoren en meet daarna de bibliotheek die u daadwerkelijk aanroept.
Bronnen
- Transcript van de keynote, inclusief de passage over het kennisfundament en de partnernamen: SB61112
- Slide gefotografeerd tijdens de keynote: ongestructureerd pad Nemotron Parse, Nemotron Embed, cuVS, Nemotron Rerank; gestructureerd pad Auto-Ontology, cuDF, Kumo.
- Aanvulling: het overzicht van de keynote