Op 21 oktober 2026 vertelde Jensen Huang op GTC Berlin de zaal dat de discussie over infrastructuur niet langer de interessante was. De fabrieken, de CUDA-stack en de GPU's waren het fundament. De vraag die hij daarna stelde, was wat je ermee doet. Engineers van Workstation zaten in de zaal in STATION-Berlin. Dit is wat hij zei, gecontroleerd aan de hand van het door NVIDIA gepubliceerde transcript van de keynote, en wat het betekent als u machines koopt in plaats van een campus van een gigawatt.
AI werd dit jaar productief
De boodschap van Huang was helder. Het afgelopen jaar werd AI productief. Hij verwees naar het begin van het jaar, toen NVIDIA sprak over OpenClaw, een opensource-agent. Dat, zei hij, is wat het patroon startte dat nu overal zichtbaar is: agents die denken, redeneren, itereren en tools gebruiken.
Nuttige agents zijn op een specifieke manier duur. Ze antwoorden niet één keer. Ze werken in lussen. Elke lus kost tokens. Meer agents, gebruikt door meer mensen, die elk veel tokens verbruiken om na te denken: daarom zei hij dat zowel het tokengebruik als de vraag naar GPU's door het dak is gegaan. In die passage toonde hij geen tokengrafiek. De bewering geeft een richting aan: agent-workloads vormen de vraag, niet één enkel chatvenster.
Vijf elementen, niet één model
Daarna definieerde hij een agent als vijf dingen. Het model is het taalmodel dat op GPU's draait en tokens produceert die de agent verbruikt. Dat noemde hij het exoskelet. De harness is het programma dat plant en tools aanroept. De harness zit in een sandbox, die hem isoleert van de rest van het systeem. De andere twee elementen zijn kennis en tools.
Zijn eigen lijst, in de volgorde waarop hij uitkwam: modellen, sandbox, harness, kennis en tools.
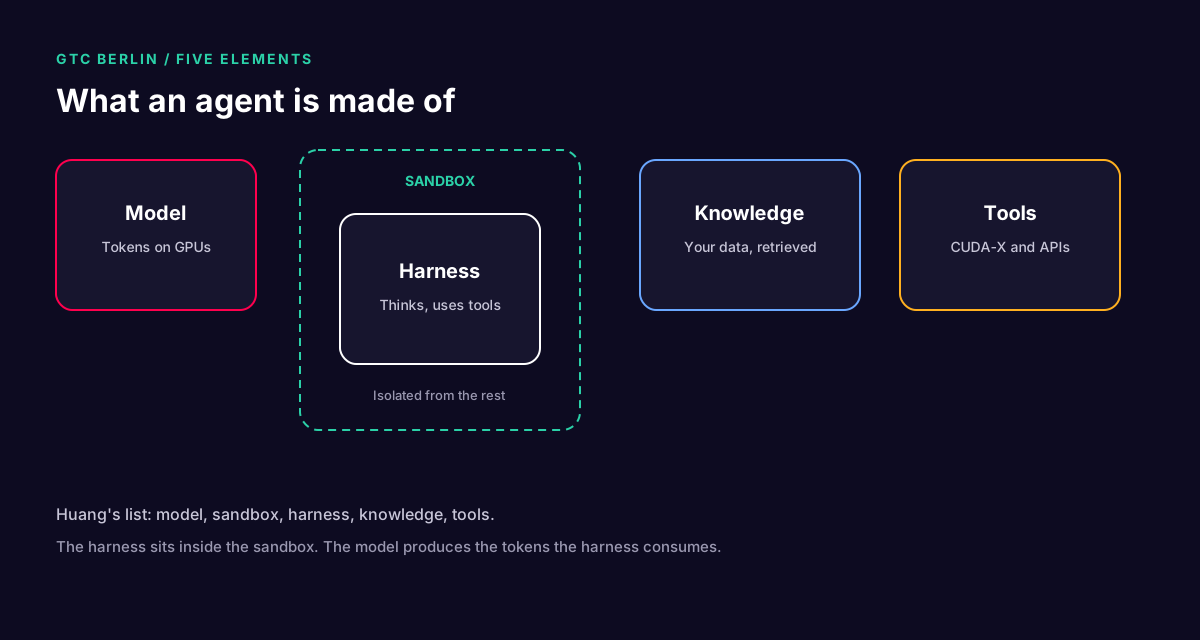
Die verdeling is het nuttige deel voor een koper. Een grotere GPU voedt alleen het model. Die bepaalt niet wat de harness mag aanraken, welke kennis hij kan zien of welke tools hij mag aanroepen. Dat zijn afzonderlijke systemen. De volgende zin van Huang was dat de agent veilig moet zijn voordat hij nuttig is, omdat hij autonoom is en bij bestanden, netwerken en tools kan komen. Rechten moeten minimaal zijn en iemand moet erop letten. Dat is de aankondiging van OpenShell, die in het begeleidende artikel wordt behandeld.
Wat de rest van de keynote hieraan ophing
Drie verdere ideeën rustten op hetzelfde kader.
- Open modellen die u kunt hertrainen. Nemotron voor taal, Cosmos voor wereldmodellen, GR00T voor robotica, Alpamayo voor autonoom rijden en Earth-2 voor fysica. Huang zei dat NVIDIA de gewichten, de data en de scripts levert, zodat een lab kan zien waar het model vandaan komt. Hij zei expliciet dat de taalmodellen niet automatisch de frontier zijn totdat een partner ze met eigen data post-traint.
- Een kennisfundament. Ongestructureerde documenten gaan door Nemotron Parse, Nemotron Embed, cuVS en Nemotron Rerank. Gestructureerde data gaat door Auto-Ontology, daarna cuDF voor analyse en Kumo voor voorspelling. Zijn uitgewerkte voorbeeld was een leveranciersvertraging in een document, orders in SQL en een zoektocht naar een vervangend onderdeel.
- De fabriek eronder. NVIDIA DSX is het full-stack referentieontwerp voor een AI-fabriek: compute, netwerk, opslag, software, stroom en koeling, uitgaande van een digital twin. De Europa-slide stapelde applicaties, modellen, AI-fabrieken, NVIDIA-compute en energie.
Wat dit betekent op een workstation
De meeste bedrijven in de zaal bouwen dit jaar geen Vera Rubin NVL72-hal. Ze draaien een harness, een sandbox en een model dat op een bureau of in één rack past. Het beeld met vijf elementen geldt nog steeds.
- Het model kan Nemotron zijn, een gesloten API, of beide. Huang zei dat elk bedrijf gesloten en open modellen zal gebruiken en zal aanpassen waar het werk bedrijfseigen is.
- De harness kan OpenClaw, Hermes, OpenHands, een LangChain- of Deep Agents-stack zijn, of Python die u zelf schrijft. Hij noemde die als manieren om de harness te bouwen die nu binnen OpenShell zit.
- Kennis bestaat uit uw documenten en uw database, niet uit een generieke crawl van het web.
- Tools zijn waar CUDA-X nog steeds telt: de bibliotheken die een agent aanroept wanneer de taak wetenschap, engineering of een ontwerpbestand is, niet weer een alinea chat.
Een Workstation-build voor die vorm is een Linux- of Mac Studio-machine met genoeg geheugen voor het model, een sandbox-runtime en een plek voor de documenten en de SQL. Het fabrieksverhaal is voor wanneer de tokensnelheid niet meer in één machine past. Huang sloot zijn referentiearchitectuur zelf af met: agents denken op Rubin, handelen op Vera en worden bestuurd op BlueField. Dat is een datacenterzin. De vijf elementen zijn het deel waarmee u op één machine kunt beginnen.
Cijfers die we niet als de onze behandelen
De newsroom van NVIDIA meldde dezelfde dag dat Vera Rubin NVL72 bij agent-workloads 30 keer de doorvoer per megawatt van de vorige generatie levert, dat Vera-CPU's tweemaal de prestaties van x86 leveren bij een hogere efficiëntie, en dat Sentry op BlueField-4 de agentcapaciteit met tot 20 procent kan verhogen. Dat zijn de cijfers van NVIDIA, uit hun persbericht, geen benchmark van Workstation. De keynote zei ook dat Vera Rubin binnen twee jaar nog eens 30 keer Blackwell is. Zelfde regel: citeer het als het hunne.
De lange technische stukken die hierop volgen behandelen OpenShell en Sentry, het kennisfundament en DSX en de Europese stack.
Een lus, geen antwoord
Een chatantwoord is één aanroep. Een agent is een keten. Het model leest een lange prompt, schrijft een tool-aanroep, de harness voert de tool uit en het resultaat gaat terug in de volgende prompt. Huangs "enorme hoeveelheid tokens" is die keten, vermenigvuldigd met het aantal agents dat tegelijk actief is. Hij zei niet dat een team tien keer sneller wordt. Hij zei dat de machines drukker worden omdat de software eindelijk werk verzet.
Als u een planningsgetal wilt, label het dan als schets. Stel dat één agentrun acht modelaanroepen is en dat iemand twintig runs per dag start. Dat zijn 160 aanroepen waar een chatbot er 20 zou zijn geweest. De GPU's zijn niet trager geworden. De vorm van het werk is veranderd. Verander de 8 of de 20 en de schets verandert. Citeer het niet als benchmark.
Wat u opschrijft voordat u koopt
Zet de vijf elementen op een overzicht voordat u een GPU kiest.
- Model. Welke gewichten, met welke precisie en hoe lang de context is die u daadwerkelijk verstuurt. Het VRAM volgt daaruit. Een model met 70 miljard parameters in 4-bit is een andere machine dan hetzelfde model in 16-bit.
- Harness. OpenClaw, Hermes, OpenHands, een framework of uw eigen Python. De harness is software die u kunt veranderen. Het is geen GPU-SKU.
- Sandbox. OpenShell, of een andere runtime die nee kan zeggen. Als u dit overslaat, delen de andere vier elementen één set rechten.
- Kennis. Welke documenten, welke database en wie ze mag ophalen.
- Tools. De paar API's en CUDA-X-bibliotheken die de taak nodig heeft. Huang zei dat de nuttige agent degene is die een echte tool kan aanroepen, en dat die tools de reden zijn dat een GPU sneller is dan dezelfde bibliotheek op een CPU. Hij sprak van 10, 50 of 100 keer. Dat was een bandbreedte vanaf het podium, geen paper.
Als dat overzicht op één workstation past, koop dan de workstation. Als de tokensnelheid een hal vereist, zit u in het DSX-gesprek. Beide kunnen in één bedrijf tegelijk waar zijn.
Bronnen
- NVIDIA on-demand-transcript, GTC Berlin 2026-keynote SB61112: nvidia.com
- NVIDIA-newsroom, 21 oktober 2026, OpenShell Reference Architecture: nvidianews.nvidia.com
- NVIDIA-blog, live-aantekeningen bij de keynote: blogs.nvidia.com