Deze gids is bedoeld voor de engineers die RTX PRO 6000 Blackwell Server Edition-systemen specificeren, in het rack plaatsen en beheren: infrastructuurleads, MLOps- en platformteams, en de mensen die het stroombudget goedkeuren. Hij behandelt wat de kaart is, hoe u GPU-geheugen dimensioneert voor echte modellen, MIG, PCIe-topologie en netwerken, stroom en koeling in het VK, de softwarestack, hoe u een nieuwe server valideert en een uitrolplan. Specificaties komen van NVIDIA's productpagina en datasheet; het rack-scale-ontwerp komt uit het gepubliceerde RackScale 32-materiaal van AMAX. Al het overige is onze eigen engineeringervaring, en we geven het aan wanneer een cijfer een schatting is.

1. De kaart in één tabel
| Onderdeel | RTX PRO 6000 Blackwell Server Edition |
|---|---|
| Architectuur | NVIDIA Blackwell |
| CUDA-cores | 24.064 |
| Tensor Cores | 752, vijfde generatie, met FP4, FP6, FP8, FP16, BF16 en TF32 en de Transformer Engine van de tweede generatie |
| RT Cores | 188, vierde generatie; 355 TFLOPS piek-RT-prestaties |
| Piek-Tensor-doorvoer (NVIDIA) | FP4 4 PFLOPS · FP8 2 PFLOPS · FP16/BF16 1 PFLOPS · TF32 234 TFLOPS |
| FP32 | 120 TFLOPS |
| Geheugen | 96 GB GDDR7 met ECC, 512-bit, 1.597 GB/s |
| Partitionering | MIG, tot 4 geïsoleerde instances |
| Media | 4 × NVENC (9e generatie, voegt 4:2:2 H.264- en HEVC-encoding toe), 4 × NVDEC (6e generatie) |
| Beeldscherm | 4 × DisplayPort 2.1 |
| Hostinterface | PCIe Gen 5 x16; geen NVLink |
| Vermogen | Tot 600 W, configureerbaar |
| Vormfactor | Lucht: dual slot, volledige hoogte, volledige lengte, passief. Vloeistof: single slot |
| Beveiliging | Secure boot met hardware root of trust |
Twee regels in die tabel bepalen de meeste ontwerpbeslissingen: 96 GB op 1,6 TB/s, wat modelgrootte, gelijktijdigheid en decodeersnelheid bepaalt, en 600 W via PCIe zonder NVLink, wat stroom, koeling en de verdeling van werk over GPU's bepaalt.
Een opmerking over de Tensor-cijfers. NVIDIA publiceert piekwaarden; de vergelijking van AMAX noemt 3,7 PFLOPS FP4 en 117 TFLOPS FP32, wat een andere aanname voor kloksnelheid of vermogen weerspiegelt. Behandel ze allemaal als plafonds. Bij LLM-inferentie met kleine batchgroottes beperkt meestal de geheugenbandbreedte, niet de Tensor-doorvoer, het aantal tokens per seconde.
2. Waar hij zit in het assortiment van NVIDIA
- Ten opzichte van de L40S: 96 GB GDDR7 in plaats van 48 GB GDDR6, 1.597 GB/s in plaats van 864 GB/s, PCIe Gen 5 in plaats van Gen 4, FP4 en MIG toegevoegd, en 600 W in plaats van 350 W. In onze ervaring past een model dat voor het geheugen twee L40S-kaarten nodig had meestal op één RTX PRO 6000.
- Ten opzichte van HGX B200/B300: HGX-boards verbinden acht GPU's met NVLink en hebben HBM3E. Ze zijn het juiste gereedschap voor training en voor zeer grote modellen die tensorparallellisme over acht GPU's nodig hebben. De RTX PRO 6000 is het juiste gereedschap voor inferentie, fine-tuning van kleine en middelgrote modellen, graphics en simulatie, in gewone luchtgekoelde racks.
- Ten opzichte van de Workstation Editions: de Workstation Edition heeft eigen ventilatoren voor een desktoptower, en de Max-Q Workstation Edition draait op 300 W. De Server Edition is passief, dus hij werkt alleen in een server die lucht erdoorheen blaast, of in de vloeistofgekoelde uitvoering.
3. GPU-geheugen dimensioneren voor LLM's
Meestal raakt eerst het geheugen op, niet de rekenkracht. Dimensioneer het in drie delen: gewichten, KV-cache en overhead.
3.1 Gewichten
Gewichten nemen parameters × bytes per parameter in beslag:
| Modelgrootte | BF16 (2 bytes) | FP8 (1 byte) | FP4 (ongeveer 0,5 byte plus schaalfactoren) |
|---|---|---|---|
| 8B | 16 GB | 8 GB | ongeveer 5 GB |
| 32B | 64 GB | 32 GB | ongeveer 18 GB |
| 70B | 140 GB | 70 GB | ongeveer 38 GB |
| 120B | 240 GB | 120 GB | ongeveer 65 GB |
De FP4-cijfers bevatten een marge voor de blokschaalfactoren die 4-bitformaten opslaan; de exacte overhead hangt af van het formaat en de tool die het model heeft gekwantiseerd. Controleer altijd de nauwkeurigheid op uw eigen evaluatieset voordat u een productiemodel naar FP8 of FP4 overzet.
3.2 KV-cache
Elk token in elk actief gesprek bewaart keys en values voor elke laag. Per token:
KV bytes per token = 2 × layers × kv_heads × head_dim × bytes per elementVoor een model uit de Llama 3.3 70B-klasse (80 lagen, 8 KV-heads met grouped-query attention, headdimensie 128) met een BF16-cache:
2 × 80 × 8 × 128 × 2 bytes = 327,680 bytes ≈ 320 KiB per token
× 32,768 tokens of context   ≈ 10 GiB per full-length conversation
FP8 KV cache                 ≈ 5 GiB per full-length conversation
3.3 Uitgewerkte voorbeelden
Ga ervan uit dat de inferentieserver 90% van elke GPU mag gebruiken (de standaardwaarde van vLLM voor --gpu-memory-utilization) en dat er per GPU een paar GB opgaat aan activaties en CUDA-graphs. Dit zijn schattingen om mee te plannen, geen garanties:
| Opstelling | Bruikbaar geheugen | Gewichten | Over voor KV-cache | Volledige 32k-gesprekken tegelijk |
|---|---|---|---|---|
| 70B FP8 op 1 GPU | ≈ 86 GB | ≈ 70 GB | ≈ 12 GB | ongeveer 1 (BF16 KV) of 2 (FP8 KV) |
| 70B FP4 op 1 GPU | ≈ 86 GB | ≈ 38 GB | ≈ 44 GB | ongeveer 4 (BF16 KV) of 8 (FP8 KV) |
| 70B FP8 op 2 GPU's, tensorparallel 2 | ≈ 173 GB | ≈ 70 GB | ≈ 95 GB | ongeveer 9 (BF16 KV) of 18 (FP8 KV) |
| 70B FP8, vier replica's op een 4U-server met acht GPU's | ≈ 691 GB | ≈ 280 GB | ≈ 380 GB | ongeveer 35 (BF16 KV) of 70 (FP8 KV) |
De meeste gesprekken zijn veel korter dan 32k tokens, en paged KV-caches bevatten alleen wat wordt gebruikt, dus de werkelijke gelijktijdigheid is meestal meerdere keren hoger. De methode blijft belangrijk: dimensioneer op basis van uw werkelijke contextlengtes en het piekaantal gelijktijdige gebruikers, niet alleen op het aantal parameters van het model.
3.4 Doorvoer, ruwweg
Bij kleine batchgroottes leest elk gegenereerd token alle gewichten één keer. Een ruw plafond voor één stream is geheugenbandbreedte ÷ bytes aan gewichten: 1.597 GB/s ÷ 70 GB ≈ 23 tokens/s voor een 70B FP8-model op één GPU, en ruwweg het dubbele in FP4. Door veel gebruikers samen te batchen stijgt de totale doorvoer ver boven het cijfer voor één stream, omdat de gewichten per stap één keer voor de hele batch worden gelezen. Benchmark uw eigen prompts met uw inferentieserver voordat u zich vastlegt op een aantal GPU's.
4. MIG: één kaart, tot vier GPU's
Multi-Instance GPU verdeelt een kaart in geïsoleerde instances, elk met eigen geheugen, cache en rekenkracht en een gegarandeerd deel van de kaart. Op de RTX PRO 6000 betekent dat tot vier instances van elk ongeveer 24 GB. Typische toepassingen:
- Meerdere kleine modellen (embeddings, rerankers, chatmodellen van 7B–8B) op één kaart, elk in een eigen instance.
- Ontwikkel- en testomgevingen voor meerdere teams zonder dat het ene team het andere tekortdoet.
- Kubernetes-clusters waarin elke pod een vast deel van de GPU moet krijgen.
De beschikbare profielen hangen af van de driverversie, dus vraag ze op uw server op in plaats van namen van elders over te nemen:
# Enable MIG mode on GPU 0 (needs the GPU to be idle; may need a GPU reset)
sudo nvidia-smi -i 0 -mig 1

# List the GPU instance profiles this card and driver support
nvidia-smi mig -i 0 -lgip

# Create instances from a profile ID shown above, with their compute instances (-C)
sudo nvidia-smi mig -i 0 -cgi <profile-id>,<profile-id> -C

# Check what you created
nvidia-smi -L
Op Kubernetes past de MIG-manager van de NVIDIA GPU Operator een MIG-indeling toe op basis van een nodelabel, waarna de device plugin elke instance als planbare resource aanbiedt. Kies de strategie single als elke GPU op een node dezelfde indeling gebruikt, en mixed als ze verschillen.
MIG is niet gratis: een model dat het geheugen van de hele kaart nodig heeft, kan niet in een kwart ervan draaien, en u kunt MIG en jobs voor de volledige kaart niet tegelijk op dezelfde GPU gebruiken. Plan welke GPU's gepartitioneerd worden en welke niet.
5. Servers en PCIe-topologie
5.1 De drie gangbare configuraties
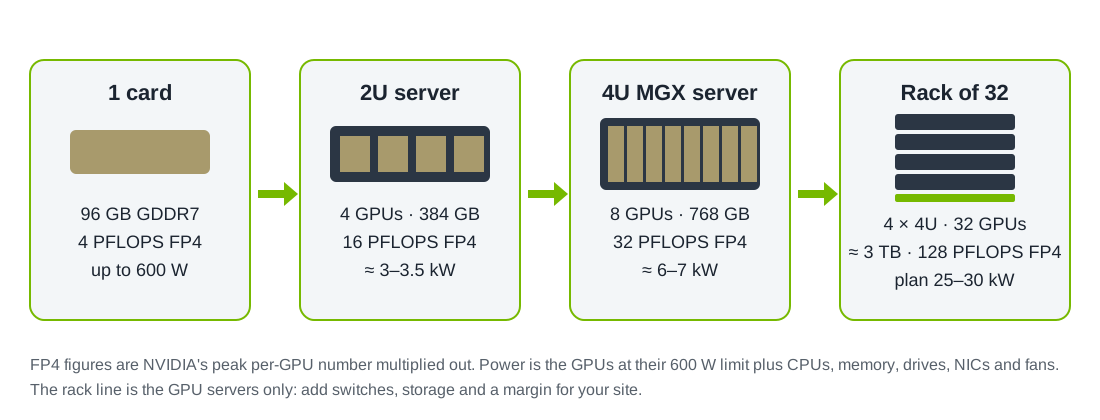
- 2U, vier GPU's. Meestal een of twee CPU's met de GPU's op directe CPU-lanes of één PCIe-switch. Goed voor één model met tensorparallellisme van 2 of 4, of meerdere replica's.
- 4U, acht GPU's op NVIDIA MGX. MGX is NVIDIA's modulaire referentieontwerp voor servers. De AceleMax AXG-428AG van AMAX is een voorbeeld: twee AMD EPYC 9005-processors, acht dual-slot GPU's, tot vijf PCIe Gen 5 x16-slots voor netwerkkaarten en tot acht E1.S NVMe-schijven.
- Een rack met 32 GPU's. Vier servers met elk acht GPU's plus de switches daartussen. AMAX publiceert dit als de RackScale 32: 32 RTX PRO 6000 Server Edition-GPU's, dual-socket EPYC 9005 per server, in totaal tot ongeveer 3 TB GDDR7 (32 × 96 GB) en 128 PFLOPS FP4, met Spectrum-X Ethernet of Quantum InfiniBand. Het is ontworpen om rack na rack te worden herhaald.
5.2 Waarom topologie belangrijk is zonder NVLink
Zonder NVLink wisselen GPU's gegevens uit via PCIe. Twee GPU's onder dezelfde PCIe-switch communiceren direct en snel met elkaar; twee GPU's op verschillende CPU-sockets moeten de verbinding tussen de sockets oversteken, en dat is trager. Controleer de indeling op elke server:
nvidia-smi topo -mIn de matrix betekent PIX of PXB tussen twee GPU's dat ze een PCIe-switchpad delen; NODE betekent dat ze op dezelfde CPU-socket zitten maar op verschillende root ports; SYS betekent dat het verkeer tussen sockets oversteekt. Praktische regels:
- Plaats de GPU's van één tensorparallelle groep op dezelfde switch of ten minste op dezelfde socket. Tensorparallellisme van 2 of 4 is op PCIe meestal het optimum.
- Voor meer GPU's per model kunt u beter pipelineparallellisme over groepen gebruiken, of meerdere replica's achter een load balancer draaien. Replica's schalen bijna lineair; breed tensorparallellisme via PCIe niet.
- Plaats elke netwerkkaart onder dezelfde PCIe-switch als de GPU's die hij bedient, zodat GPUDirect RDMA gegevens tussen GPU-geheugen en het netwerk kan verplaatsen zonder de CPU te belasten. Sommige nieuwere RTX PRO-serverontwerpen hebben dit ingebouwd door NVIDIA ConnectX-8 SuperNICs te gebruiken, die een PCIe-switch bevatten.
6. Netwerken tussen servers
Eén server heeft alleen gewone datacenternetwerken nodig. Zodra een workload meerdere servers omvat, zoals bij gedistribueerde fine-tuning, zeer grote modellen die over nodes zijn verdeeld of een gedeelde inferentievloot met snel laden van modellen, wordt het netwerk belangrijk.
- Bandbreedte: plan één poort van 400 Gb/s voor elke een of twee GPU's op servers die multi-node jobs draaien. Een MGX-server met acht GPU's en vier of vijf kaarten van 400 Gb/s is een gangbare configuratie.
- Fabric: NVIDIA Spectrum-X Ethernet (Spectrum-4-switches met ConnectX- of BlueField-netwerkkaarten, met RoCE) of Quantum InfiniBand. Spectrum-X past bij teams die al Ethernet gebruiken; InfiniBand past bij HPC-teams die eraan gewend zijn.
- Gescheiden netwerken: houd de GPU-fabric gescheiden van het opslagnetwerk en van beheer (BMC en out-of-band). Ze mengen is de gebruikelijke oorzaak van onvoorspelbare jobtijden.
- Opslag: lokale E1.S- of U.2 NVMe voor modelgewichten en scratch, en een parallel of NVMe-over-fabrics-bestandssysteem als veel servers dezelfde grote modellen laden.
Voor inferentievloten waarbij elk verzoek op één server draait, is 100 of 200 Gb/s per server meestal voldoende.
7. Stroom en koeling in Britse ruimtes
7.1 Stroombudget
| Systeem | GPU-vermogen bij 600 W | Heel systeem, geschat |
|---|---|---|
| 2U, 4 GPU's | 2,4 kW | ongeveer 3 tot 3,5 kW |
| 4U, 8 GPU's | 4,8 kW | ongeveer 6 tot 7 kW |
| Rack, 32 GPU's | 19,2 kW | ongeveer 25 tot 30 kW, exclusief netwerkswitches en opslag |
"Heel systeem" telt CPU's, geheugen, schijven, netwerkkaarten, ventilatoren en verliezen van de voeding mee. Gebruik de stroomcalculator van de fabrikant voor de exacte configuratie voordat u een offerte definitief maakt.
In Britse termen levert een eenfasige aansluiting van 32 A op 230 V ongeveer 7,4 kW, genoeg voor één server met acht GPU's met weinig marge. Een rack met 32 GPU's heeft driefasestroom nodig: een driefasige aansluiting van 32 A op 400 V levert ongeveer 22 kW, dus plan twee aansluitingen per rack, met een A- en B-kant voor redundante voedingen. Veel bestaande Britse serverruimtes zijn gebouwd voor 5 tot 10 kW per rack, dus het ontwerp met 32 GPU's betekent meestal een colocatielocatie of een upgrade van de ruimte.
7.2 Vermogenslimieten
De vermogenslimiet van de kaart is configureerbaar. Door hem te verlagen levert u wat piekprestaties in, in ruil voor meer GPU's binnen dezelfde stroomvoorziening en koeling. LLM-decoding, dat door geheugenbandbreedte wordt beperkt, verliest vaak minder dan het bespaarde vermogen, maar meet het op uw eigen workload.
# Show the allowed range and the current limit
nvidia-smi -q -d POWER

# Set GPU 0 to 450 W (must be inside the allowed range; resets at reboot)
sudo nvidia-smi -i 0 -pl 450
Pas de limiet bij het opstarten toe met een systemd-unit of uw configuratiebeheer, en leg hem vast in het assetregister zodat supportmedewerkers weten waarom een GPU onder zijn maximum draait.
7.3 Koeling
- Elke kilowatt wordt ongeveer 3.412 BTU/h aan warmte. Een rack van 30 kW gaat verder dan wat de meeste luchtgekoelde ruimtes per rack kunnen afvoeren zonder containment of warmtewisselaars in de achterdeur.
- De luchtgekoelde kaart is passief: hij is afhankelijk van de ventilatoren van de server en van koele aanzuiglucht. Houd de aanzuigtemperaturen binnen de limieten van de serverfabrikant, gebruik blindpanelen en scheid warme en koude gangen.
- De vloeistofgekoelde single-slotversie past bij compacte configuraties op locaties die al vloeistofkoeling hebben. Het is geen retrofit voor een luchtgekoelde ruimte.
8. De softwarestack
- Besturingssysteem: een actuele LTS-distributie die door de serverfabrikant en NVIDIA wordt ondersteund, zoals Ubuntu Server 22.04 of 24.04 LTS of Red Hat Enterprise Linux 9.
- Driver: een NVIDIA-datacenterdrivertak die Blackwell ondersteunt. Blackwell-GPU's hebben de open GPU-kernelmodules van NVIDIA nodig, en CUDA 12.8 of later.
- Containers: de NVIDIA Container Toolkit, geconfigureerd voor uw runtime.
- Orkestratie: de NVIDIA GPU Operator op Kubernetes, of Slurm voor batchwerk.
- Serving: vLLM, SGLang, TensorRT-LLM of NVIDIA NIM-microservices voor LLM's; Omniverse en uw renderer voor grafisch werk; RAPIDS voor data science.
- Monitoring: NVIDIA DCGM met dcgm-exporter naar Prometheus en Grafana.
# Container runtime (Docker shown)
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker

# Kubernetes: the GPU Operator from NVIDIA's Helm repository
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia && helm repo update
helm install --wait gpu-operator -n gpu-operator --create-namespace nvidia/gpu-operator
Een OpenAI-compatibel endpoint voor een 70B-model op twee GPU's, met FP8-gewichten en een FP8 KV-cache:
docker run --gpus '"device=0,1"' --ipc=host -p 8000:8000 \
  -v /models/hf:/root/.cache/huggingface \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.3-70B-Instruct \
  --tensor-parallel-size 2 \
  --quantization fp8 \
  --kv-cache-dtype fp8 \
  --max-model-len 32768 \
  --gpu-memory-utilization 0.90
Pin het image in productie op een geteste versie in plaats van latest, en houd de modelgewichten op lokale NVMe zodat herstarts snel gaan.
9. Een nieuwe server valideren
We voeren deze controles uit op elk systeem voordat het de werkplaats verlaat, en opnieuw op locatie:
# 1. Every GPU present, at the expected memory, power limit and PCIe link
nvidia-smi --query-gpu=index,name,memory.total,power.limit,pcie.link.gen.current,pcie.link.width.current --format=csv

# 2. ECC enabled and no uncorrectable errors
nvidia-smi -q -d ECC

# 3. Topology as designed (GPU and NIC pairs under the same switch)
nvidia-smi topo -m

# 4. NVIDIA's diagnostics, long run
dcgmi diag -r 3

# 5. GPU-to-GPU bandwidth inside the server (from NVIDIA's nccl-tests)
./build/all_reduce_perf -b 8 -e 4G -f 2 -g 8
Draai daarna een burn-in van enkele uren op volle belasting, indien mogelijk met de echte inferentie- of renderworkload, terwijl u temperaturen, kloksnelheden en vermogen in de gaten houdt. Een kaart die in de werkplaats throttelt, throttelt erger in een warme gang.
Nuttige DCGM-metrics om in productie op te alerteren: DCGM_FI_DEV_GPU_TEMP, DCGM_FI_DEV_POWER_USAGE, DCGM_FI_DEV_FB_USED, DCGM_FI_DEV_GPU_UTIL en de XID-foutmeldingen in het systeemlog.
10. Een uitrolplan
- Benchmark (1–2 weken). Draai uw modellen en prompts op één RTX PRO 6000-server. Leg tokens per seconde, time to first token en geheugengebruik vast bij uw werkelijke contextlengtes en gelijktijdigheid. Bepaal de precisie (BF16, FP8 of FP4) op basis van de nauwkeurigheid op uw eigen evaluatieset.
- Dimensioneren en inventariseren (1 week). Vertaal de benchmark naar een aantal GPU's met marge, en controleer daarna stroom, koeling, netwerk en rackruimte op de locatie.
- Bouwen en burn-in. Identieke configuratie voor elke server: firmware, BIOS-instellingen, driver, vermogenslimiet en MIG-indeling onder configuratiebeheer.
- Pilot. Eén team, één dienst, met monitoring en een on-callroute op hun plaats voordat de gebruikers komen.
- Opschalen. Voeg servers van dezelfde configuratie toe. Stap pas over op een fabric tussen servers wanneer een workload ze werkelijk omvat.
11. Vragen die we krijgen
Kunnen we RTX PRO 6000- en L40S-kaarten in één server combineren? Technisch gezien wel, maar zet ze niet in dezelfde tensorparallelle groep. Houd elk model op één GPU-type, en gebruik de scheduler om werk te plaatsen.
Is FP4 goed genoeg? Voor veel instruction-tuned modellen met goede 4-bitcheckpoints wel; bij sommige taken, zoals code, wiskunde en lange redeneerketens, daalt de nauwkeurigheid meer. Test op uw eigen data. FP8 is de veilige standaard.
Kunnen we erop fine-tunen? Ja, voor parameter-efficiënte fine-tuning (LoRA en QLoRA) van kleine en middelgrote modellen, en volledige fine-tuning van kleinere modellen. Voor volledige fine-tuning van modellen uit de 70B-klasse of pre-training zijn HGX-systemen met NVLink het betere gereedschap.
Zijn er speciale licenties nodig? De driver en CUDA zijn gratis. NVIDIA AI Enterprise (inclusief NIM) en de virtuele GPU-software van NVIDIA worden apart gelicentieerd; opensourcestacks zoals vLLM hebben ze niet nodig.
Bronnen
- NVIDIA: RTX PRO 6000 Blackwell Server Edition, specificaties
- AMAX: RackScale 32 met NVIDIA RTX PRO 6000 Blackwell Server Edition
- AMAX: AceleMax AXG-428AG
- AMAX: RTX PRO 6000 Blackwell Server Edition vs NVIDIA L40S
Voor de businesscase en de systemen die wij leveren, zie de pagina over de RTX PRO 6000 Blackwell Server Edition en onze blogpost.
Handelsmerken. NVIDIA, het NVIDIA-logo, RTX, RTX PRO, Blackwell, CUDA, NVLink, MGX, Omniverse, Spectrum-X, Quantum, BlueField, ConnectX, TensorRT, NIM en DCGM zijn handelsmerken en/of gedeponeerde handelsmerken van NVIDIA Corporation in de VS en andere landen. AMAX en AceleMax zijn handelsmerken van AMAX Engineering Corporation. AMD en EPYC zijn handelsmerken van Advanced Micro Devices, Inc. Llama is een handelsmerk van Meta Platforms, Inc. Ubuntu is een handelsmerk van Canonical Ltd. Red Hat is een handelsmerk van Red Hat, Inc. Kubernetes is een handelsmerk van The Linux Foundation. Docker is een handelsmerk van Docker, Inc. Alle andere handelsmerken zijn eigendom van hun respectieve eigenaars. Workstation is een onafhankelijke leverancier; er wordt geen goedkeuring door deze bedrijven gesuggereerd. De video is van NVIDIA.